Os gráficos de calor, também conhecidos como “mapas de calor” ou “blocos/ladrilhos de calor” (do inglês heat tiles) , podem ser visualizações úteis ao tentar exibir 3 variáveis (eixo x, eixo y e preenchimento). Abaixo, demonstramos dois exemplos:
Este pedaço de código mostra o carregamento de pacotes necessários para as análises. Neste manual, enfatizamos p_load() do pacman, que instala o pacote se necessário e o carrega para uso. Você também pode carregar pacotes instalados com library() do R base. Veja a página em Introdução ao R para mais informações sobre pacotes R.
pacman::p_load(
  tidyverse, # manipulação e visualização de dados
  rio, # importando dados
  lubridate, # trabalhando com datas
  appliedepidata # dados de exemplo utilizados neste manual
  )
Conjuntos de dados
Esta página utiliza a lista de casos de um surto simulado para a seção de matriz de transmissão e um conjunto de dados separado de contagens diárias de casos de malária por instalação para a seção de rastreamento de métricas. Eles são carregados e limpos em suas seções individuais.
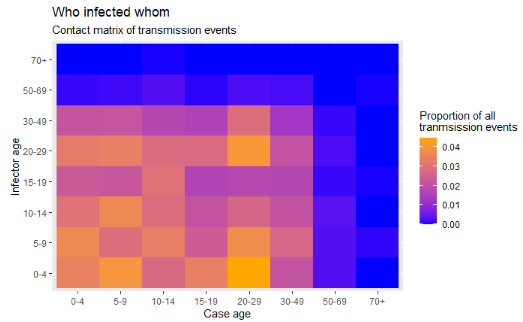
Os quadrados de um mapa de calor podem ser úteis para visualizar matrizes. Um exemplo é exibir “quem infectou quem” em um surto. Isso pressupõe que você tenha informações sobre os eventos de transmissão.
Observe que a página Rastreamento de contato contém outro exemplo de criação de uma matriz de contato de do tipo blocos/quadrados térmicos, usando um conjunto de dados diferente (talvez até mais simples) onde as idades dos casos e suas fontes estão perfeitamente alinhadas na mesma linha de observação do quadro de dados (data frame). Esses mesmos dados são usados para fazer um mapa de densidade na página dicas do ggplot. O exemplo abaixo começa com uma linelist de caso e, portanto, envolve uma manipulação considerável de dados antes de obter um data frame que possa ser utilizado em um gráfico. Portanto, existem muitos cenários para escolher…
Começamos com a lista de casos de uma simulação de epidemia de Ebola. Carregue diretamente com appliedepidata::get_data(name = "linelist_cleaned_rds") (consulte a página Baixar manual e dados para mais detalhes).
As primeiras 50 linhas da linelist são mostradas abaixo para demonstração:
linelist <- appliedepidata::get_data(name = "linelist_cleaned_rds")Nesta linelist:
case_idinfector que contém ocase_id do infectador, que também é um caso na linelistObjetivo: Precisamos alcançar um data frame de estilo “longo” que contenha uma linha por rota de transmissão de idade a idade possível, com uma coluna com valores numéricos contendo a proporção dessa linha de todos os eventos de transmissão observados na linelist.
Isso exigirá várias etapas de manipulação de dados para alcançar:
Para começar, criamos um data frame dos casos, suas idades e seus infectantes - chamamos o data frame de case_ages. As primeiras 50 linhas são exibidas abaixo.
case_ages <- linelist %>%
  select(case_id, infector, age_cat) %>%
rename("case_age_cat" = "age_cat")A seguir, criamos um data frame dos infectantes - no momento, ele consiste em uma única coluna. Estas são as IDs de infecção da linelist. Nem todos os casos têm um infectante conhecido, por isso removemos os valores ausentes. As primeiras 50 linhas são exibidas abaixo.
infectors <- linelist %>%
  select(infector) %>%
  drop_na(infector) %>%
  distinct()
Em seguida, usamos junções para obter as idades dos infectantes. Isso não é simples, pois na linelist, as idades do infectador não são listadas como tal. Alcançamos esse resultado juntando a ‘linelist’ dos casos a dos infectantes. Começamos com os infectantes e fazemos um left_join() ( ou seja, o adicionamos) com o linelist, de forma que o data frame de infectates seja a “linha de base” e a coluna infector do lado esquerdo se junte à coluna case_id na linelist a direita.
Assim, os dados do registro do caso do infectante na linelist (incluindo a idade) são adicionados à linha do infectante. As 50 primeiras linhas são exibidas abaixo.
infector_ages <- infectors %>%             # begin with infectors
  left_join(# adiciona os dados da linelist para cada infectador
    linelist,
    by = c("infector" = "case_id")) %>%    # match infector to their information as a case
  select(infector, age_cat) %>%            # keep only columns of interest
  rename("infector_age_cat" = "age_cat")   # rename for clarity
Em seguida, combinamos os casos e suas idades com os infectantes e suas idades. Cada um desses data frame tem a coluna infector, então ela é usada para a junção. As primeiras linhas são exibidas abaixo:
ages_complete <- case_ages %>%
  left_join(
    infector_ages,
    by = "infector") %>%        # each has the column infector
  drop_na() # excluir linhas com qualquer dado faltante
Abaixo, uma tabulação cruzada simples de contagens entre os casos e os grupos de idade dos infectantes. Rótulos foram adicionadas para maior clareza.
table(cases = ages_complete$case_age_cat,
      infectors = ages_complete$infector_age_cat)
infectors
cases 0-4 5-9 10-14 15-19 20-29 30-49 50-69 70+
0-4 68 80 64 55 78 58 6 0
5-9 57 73 60 63 70 59 7 2
10-14 60 61 52 47 68 43 7 2
15-19 53 55 51 23 43 38 3 2
20-29 67 71 63 46 79 55 8 1
30-49 45 52 34 31 59 31 2 2
50-69 4 5 7 6 2 4 1 0
70+ 1 0 1 0 0 0 0 0Podemos converter esta tabela em um dataframe com data.frame() do R base, que também converte automaticamente para o formato “longo”, que é desejado para o ggplot(). As primeiras linhas são mostradas abaixo.
long_counts <- data.frame(table(
    cases     = ages_complete$case_age_cat,
    infectors = ages_complete$infector_age_cat))
Agora fazemos o mesmo, mas aplicamos prop.table() do R base para a tabela de forma que, em vez de contagens, obtenhamos proporções do total. As primeiras 50 linhas são mostradas abaixo.
long_prop <- data.frame(prop.table(table(
    cases = ages_complete$case_age_cat,
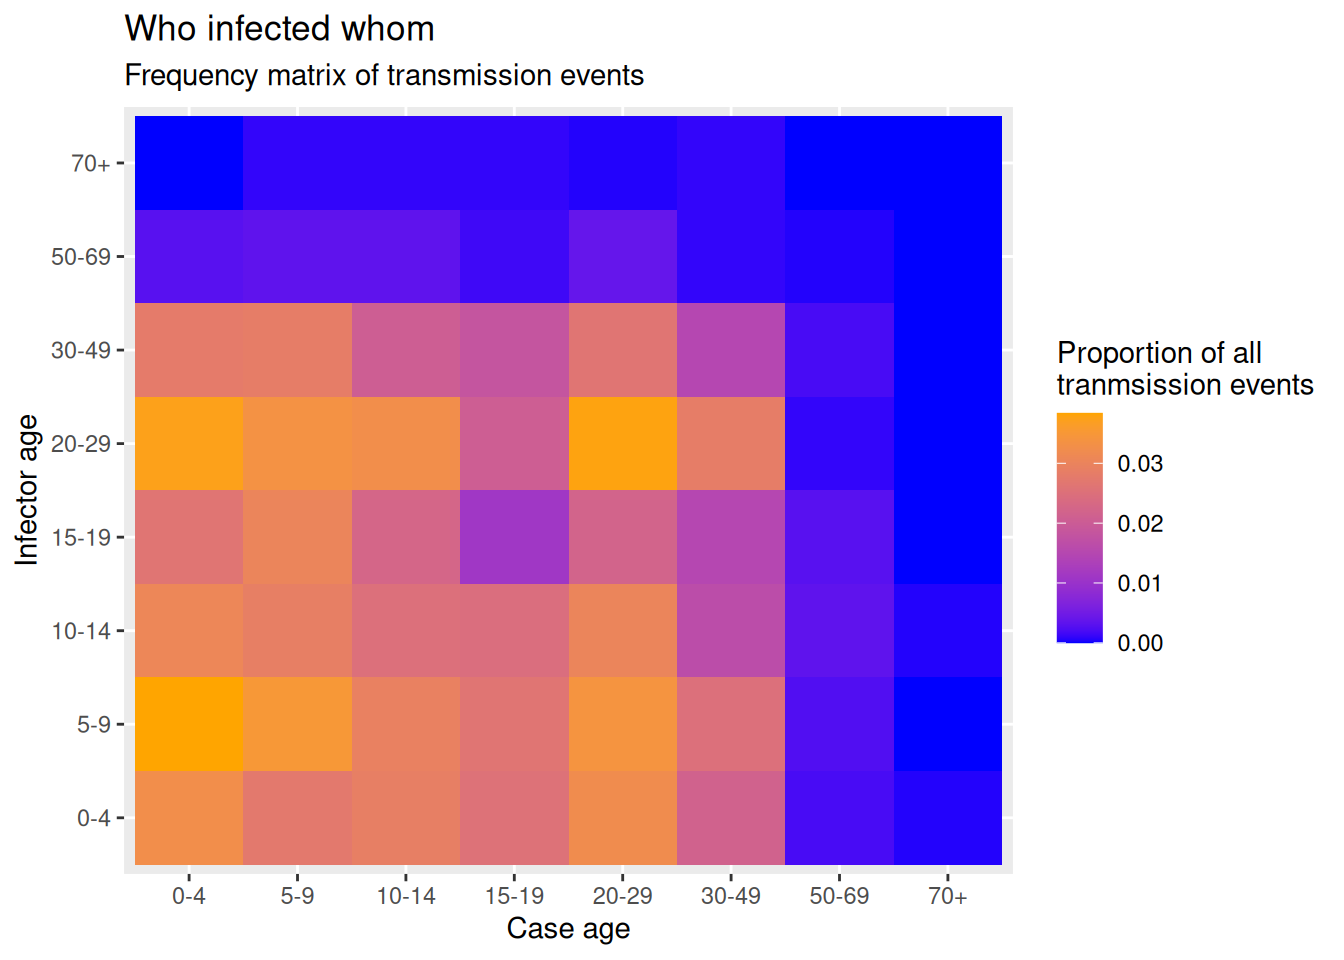
infectors = ages_complete$infector_age_cat)))Agora, finalmente, podemos criar o gráfico de calor com o pacote ggplot2, usando a função geom_tile(). Veja a página de dicas do ggplot para aprender mais extensivamente sobre as escalas de cor / preenchimento, especialmente a função scale_fill_gradient().
aes() de geom_tile() defina x e y como a idade do caso e idade infectanteaes() defina o argumento fill = para a coluna Freq - este é o valor que será convertido para uma cor de blocoscale_fill_gradient() - você pode especificar as cores altas / baixas
scale_color_gradient() é diferente! Neste caso, você quer o preenchimentofill = em labs() para alterar o título da legendaggplot(data = long_prop)+ # use long data, with proportions as Freq
geom_tile(# visualizar em quadrados
aes(
x = cases, # eixo x é a idade do caso
y = infectors, # eixo y é a idade do infectador
fill = Freq))+ # color of the tile is the Freq column in the data
scale_fill_gradient(# ajusta a cor de preenchimento dos quadrados
low = "blue",
high = "orange")+
labs(# rótulos
x = "Case age",
y = "Infector age",
title = "Who infected whom",
subtitle = "Frequency matrix of transmission events",
fill = "Proportion of all\ntranmsission events" # legend title
)
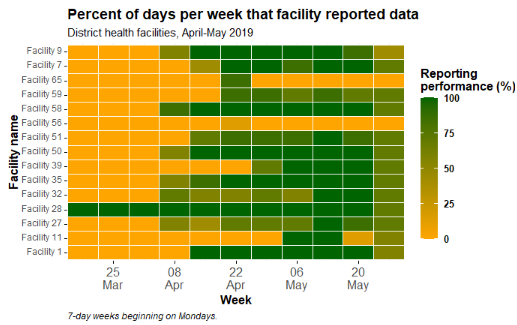
Frequentemente, na saúde pública, um objetivo é avaliar as tendências ao longo do tempo para muitas entidades (instalações, jurisdições, etc.). Uma maneira de visualizar essas tendências ao longo do tempo é um gráfico de calor em que o eixo x é o tempo e no eixo y estão as várias entidades.
Começamos importando um conjunto de dados de relatórios diários da malária de muitos estabelecimentos. Os relatórios contêm uma data, província, distrito e contagens de malária. Consulte a página em Baixar manual e dados para obter informações sobre como baixar esses dados. Abaixo estão as primeiras 30 linhas:
facility_count_data <- appliedepidata::get_data(name = "malaria_facility_count_data")O objetivo neste exemplo é transformar as contagens diárias de casos de malária total dos estabelecimentos (visto na guia anterior) em estatísticas resumidas semanais de desempenho de relatórios das instalações - neste caso a proporção de dias por semana que a instalação/estabelecimento relatou quaisquer dados. Para este exemplo, mostraremos dados apenas para Spring District.
Para conseguir isso, faremos as seguintes etapas de gerenciamento de dados:
floor_date() do pacote lubridate
summarise() cria novas colunas para refletir as estatísticas de resumo por grupo de semana-estabelecimento:
right_join() a uma lista abrangente de todas as combinações possíveis de semana-estabelecimento, para tornar o conjunto de dados completo. A matriz de todas as combinações possíveis é criada aplicando expand() a essas duas colunas dodata frame, como está naquele momento na cadeia de pipes (representado por .). Como um right_join() é usado, todas as linhas no data frame expand() são mantidas e adicionadas a agg_weeks se necessário. Essas novas linhas aparecem com valores resumidos NA (ausentes).Abaixo, demonstramos passo a passo:
# Crie um conjunto de dados de resumo semanal
agg_weeks <- facility_count_data %>%

  # filtrar os dados conforme apropriado
  filter(
    District == "Spring",
    data_date < as.Date("2020-08-01"))
Agora o conjunto de dados tem nrow(agg_weeks) linhas, quando anteriormente tinha nrow(facility_count_data).
Em seguida, criamos uma coluna week refletindo a data de início da semana para cada registro. Isso é obtido com o pacote lubridate e a função floor_date(), que é definida como “semana” e para as semanas com início às segundas-feiras (dia 1 da semana - domingos seria 7). As linhas superiores são mostradas abaixo.
agg_weeks <- agg_weeks %>%
  # Crie a coluna da semana a partir de data_date
  mutate(
    week = lubridate::floor_date(# criar uma nova coluna de semanas
      data_date,  # date
      unit = "week", # dá o início da semana
      week_start = 1)) # semanas para começar às segundas-feiras
A nova coluna da semana pode ser vista na extremidade direita do quadro de dados
Agora agrupamos os dados em semana-instalação e os resumimos para produzir estatísticas por semana-instalação. Consulte a página em Tabelas descritivas para dicas. O próprio agrupamento não altera o quadro de dados, mas impacta como as estatísticas de resumo subsequentes são calculadas.
As linhas superiores são mostradas abaixo. Observe como as colunas mudaram completamente para refletir as estatísticas de resumo desejadas. Cada linha reflete uma semana-instalação.
agg_weeks <- agg_weeks %>%

  # Grupo em semana-estabelecimento
  group_by(location_name, week) %>%

  # Crie colunas de estatísticas de resumo nos dados agrupados
  summarize(
    n_days          = 7,                                          # 7 days per week
    n_reports       = dplyr::n(),                                 # number of reports received per week (could be >7)
    malaria_tot     = sum(malaria_tot, na.rm = T),                # total malaria cases reported
    n_days_reported = length(unique(data_date)),                  # number of unique days reporting per week
    p_days_reported = round(100*(n_days_reported / n_days))) %>%  # percent of days reporting

  ungroup(location_name, week)                                    # ungroup so expand() works in next step
Por fim, executamos o comando abaixo para garantir que TODAS as semanas-estabelecimento possíveis estejam presentes nos dados, mesmo que não existissem antes.
Estamos usando um right_join() em si mesmo (o conjunto de dados é representado por “.”), Mas foi expandido para incluir todas as combinações possíveis das colunas week e location_name. Veja a documentação sobre a função expand() na página Pivoteando Dados. Antes de executar este código, o conjunto de dados contém linhas nrow(agg_weeks).
# Crie um dataframe com todas as possibilidades de combinação semana-estabelecimento
expanded_weeks <- agg_weeks %>%
  tidyr::expand(location_name, week) # expanda data frame para incluir todas as combinações possíveis de semana-estabelecimento
Aqui está expanded_weeks, com 180 linhas:
Antes de executar este código, agg_weeks contém 107 linhas.
# Use uma junção à direita com a lista expandida semana-estabelecimento para preencher as lacunas que faltam nos dados
agg_weeks <- agg_weeks %>%
  right_join(expanded_weeks, by = c("location_name", "week")) %>%  # Ensure every possible facility-week combination appears in the data
  mutate(p_days_reported = replace_na(p_days_reported, 0)) # converter valores ausentes para 0
Depois de executar este código, agg_weeks contém linhas nrow(agg_weeks).
O ggplot() é feito usando geom_tile() do pacote ggplot2:
scale_x_date()location_name no eixo y mostrará todos os nomes de estabelecimentosfill é p_days_reported, o desempenho para aquela semana-estabelecimento(numérico)scale_fill_gradient() é usado no preenchimento numérico, especificando cores para alto, baixo e NAscale_x_date() é usado no eixo x especificando rótulos a cada 2 semanas e seu formatoUm gráfico de calor básico é produzido abaixo, usando as cores e escalas padrão. Como explicado acima, dentro de aes() para geom_tile() você deve fornecer uma coluna do eixo x, coluna do eixo y e uma coluna para o fill =. O preenchimento é o valor numérico apresentado como cor do bloco.
ggplot(data = agg_weeks)+
  geom_tile(
    aes(x = week,
        y = location_name,
        fill = p_days_reported))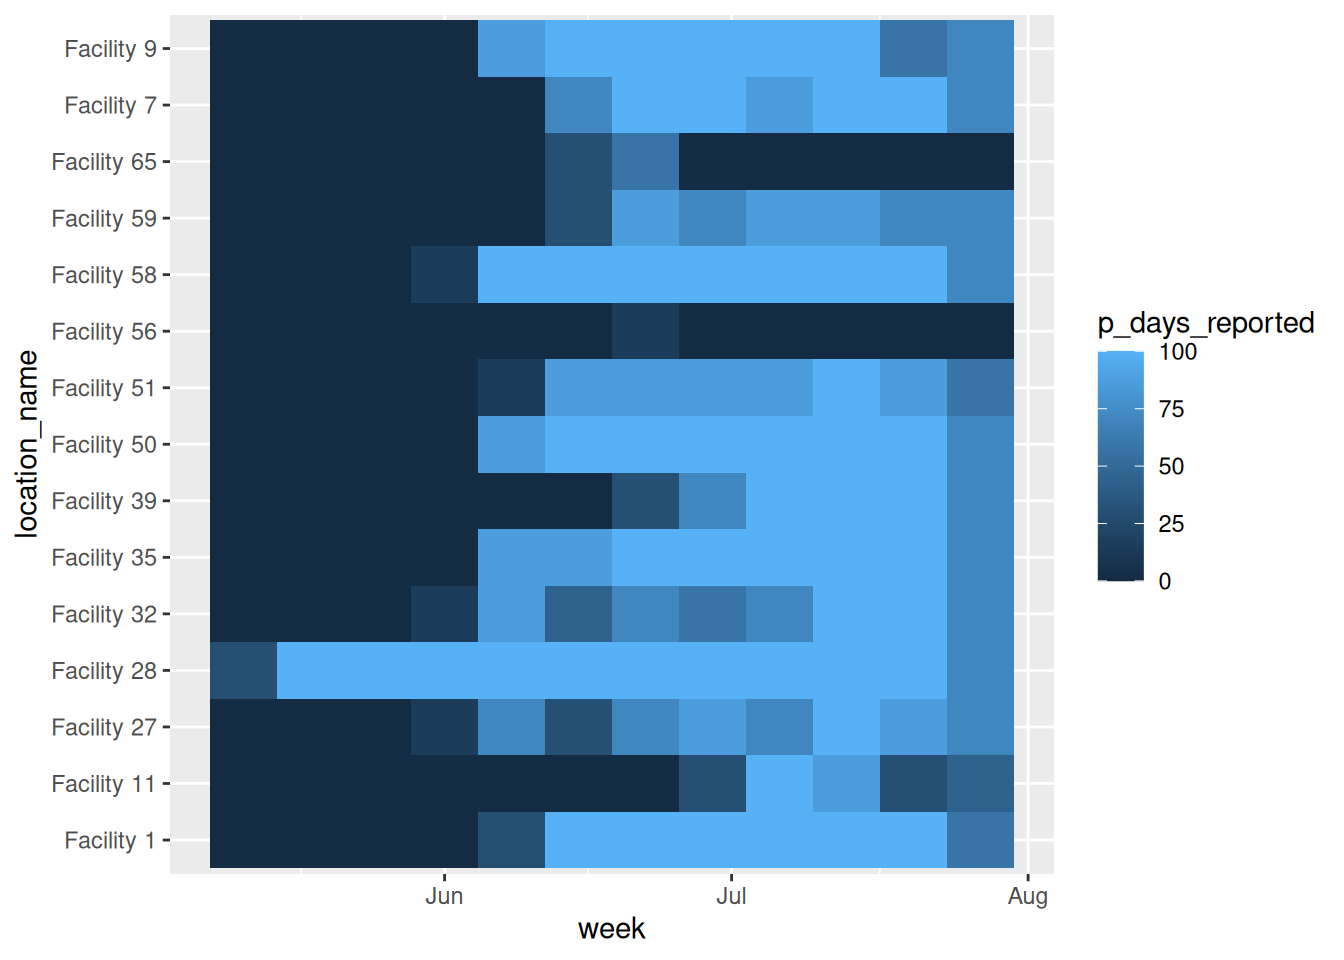
Podemos fazer esse gráfico parecer melhor adicionando funções ggplot2 adicionais, conforme mostrado abaixo. Veja a página em dicas do ggplot para detalhes.
ggplot(data = agg_weeks)+

  # mostrar dados como quadrados
  geom_tile(
    aes(x = week,
        y = location_name,
        fill = p_days_reported),
    color = "white")+                 # white gridlines

  scale_fill_gradient(
    low = "orange",
    high = "darkgreen",
    na.value = "grey80")+

  # eixo de data
  scale_x_date(
    expand = c(0,0), # remove espaço extra nas laterais
    date_breaks = "2 weeks", # rótulos a cada 2 semanas
    date_labels = "%d\n%b")+     # format is day over month (\n in newline)

  # temas estéticos
  theme_minimal()+                                  # simplify background

  theme(
    legend.title = element_text(size=12, face="bold"),
    legend.text  = element_text(size=10, face="bold"),
    legend.key.height = grid::unit(1,"cm"),           # height of legend key
    legend.key.width  = grid::unit(0.6,"cm"),         # width of legend key

    axis.text.x = element_text(size=12),              # axis text size
    axis.text.y = element_text(vjust=0.2),            # axis text alignment
    axis.ticks = element_line(linewidth=0.4),
    axis.title = element_text(size=12, face="bold"),  # axis title size and bold

    plot.title = element_text(hjust=0,size=14,face="bold"),  # title right-aligned, large, bold
    plot.caption = element_text(hjust = 0, face = "italic") # legenda alinhado à direita e itálico
    )+

  # rótulos de gráfico
  labs(x = "Week",
       y = "Facility name",
       fill = "Reporting\nperformance (%)",           # legend title, because legend shows fill
       title = "Percent of days per week that facility reported data",
       subtitle = "District health facilities, May-July 2020",
       caption = "7-day weeks beginning on Mondays.")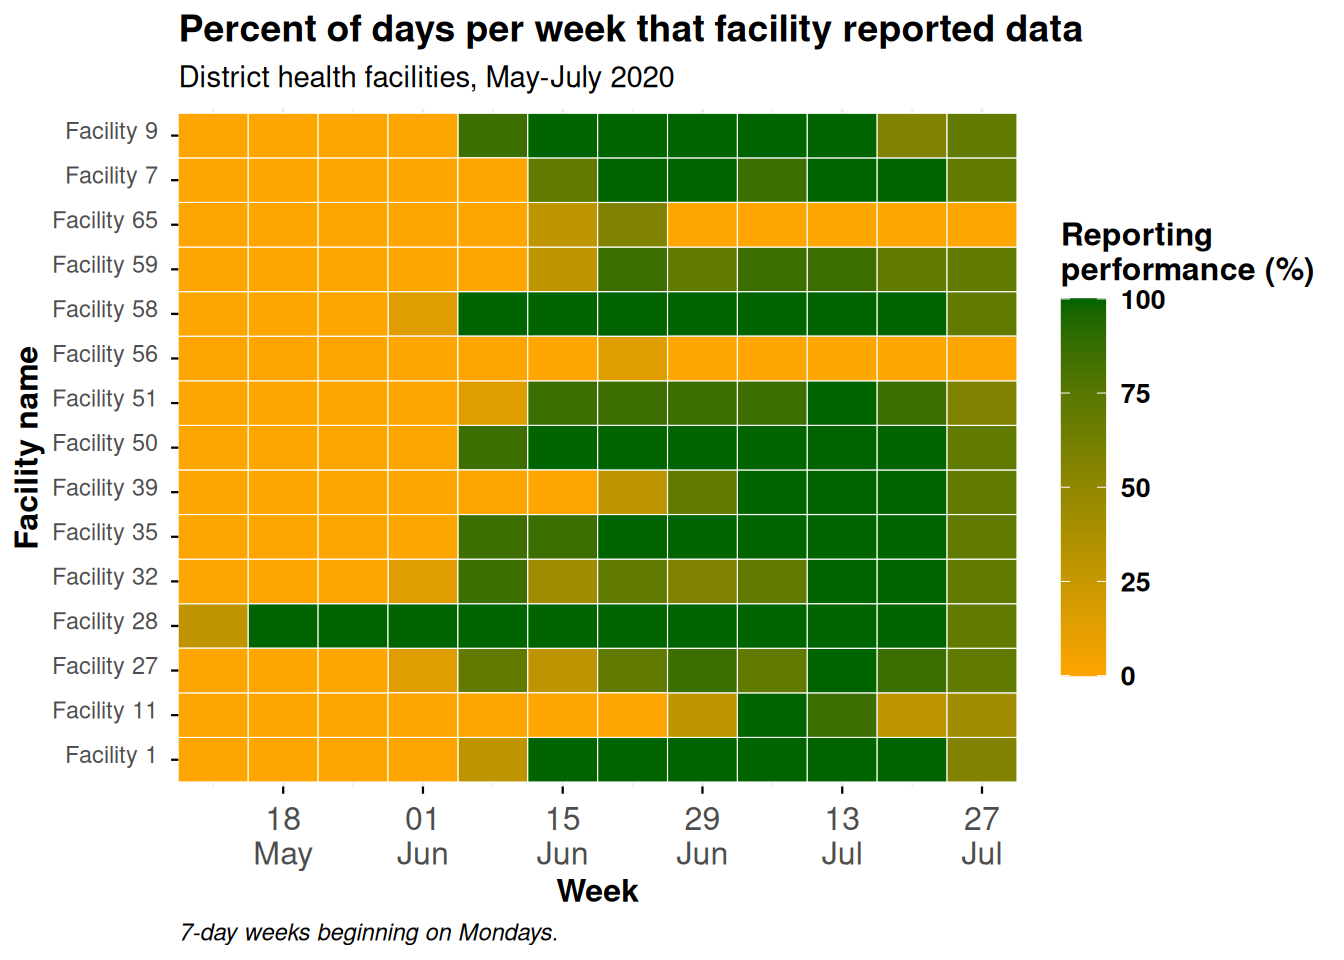
Atualmente, as instalações são ordenadas “alfanumericamente” de baixo para cima. Se você quiser ajustar a ordem das facilidades do eixo y, converta-as em fator de classe e forneça a ordem. Veja a página em Fatores para dicas.
Uma vez que existem muitos recursos e não queremos escrevê-los todos, tentaremos outra abordagem - ordenar os recursos em um data frame e usar a coluna de nomes resultante como a ordem dos níveis do fator. Abaixo, a coluna location_name é convertida em um fator, e a ordem de seus níveis é definida com base no número total de dias de relatório arquivados pela instalação/estabelecimento ao longo de todo o período de tempo.
Para fazer isso, criamos um data frame que representa o número total de relatórios por instalação, organizados em ordem crescente. Podemos usar este vetor para ordenar os níveis dos fatores no gráfico.
facility_order <- agg_weeks %>%
  group_by(location_name) %>%
  summarize(tot_reports = sum(n_days_reported, na.rm=T)) %>%
  arrange(tot_reports) # ordem crescente
Veja o data frame abaixo:
Agora use uma coluna do data frame acima (facility_order$location_name) para ser a ordem dos níveis de fator de location_name no quadro de dados agg_weeks:
# Carregar pacote
pacman::p_load(forcats)

# criar fator e definir níveis manualmente
agg_weeks <- agg_weeks %>%
  mutate(location_name = fct_relevel(
    location_name, facility_order$location_name)
    )
E agora os dados são adicionados a um gráfico novamente, com location_name sendo um fator ordenado:
ggplot(data = agg_weeks)+

  # mostrar dados como quadrados
  geom_tile(
    aes(x = week,
        y = location_name,
        fill = p_days_reported),
    color = "white")+                 # white gridlines

  scale_fill_gradient(
    low = "orange",
    high = "darkgreen",
    na.value = "grey80")+

  # eixo de data
  scale_x_date(
    expand = c(0,0), # remove espaço extra nas laterais
    date_breaks = "2 weeks", # rótulos a cada 2 semanas
    date_labels = "%d\n%b")+     # format is day over month (\n in newline)

  # temas estéticos
  theme_minimal()+                                  # simplify background

  theme(
    legend.title = element_text(size=12, face="bold"),
    legend.text  = element_text(size=10, face="bold"),
    legend.key.height = grid::unit(1,"cm"),           # height of legend key
    legend.key.width  = grid::unit(0.6,"cm"),         # width of legend key

    axis.text.x = element_text(size=12),              # axis text size
    axis.text.y = element_text(vjust=0.2),            # axis text alignment
    axis.ticks = element_line(linewidth=0.4),
    axis.title = element_text(size=12, face="bold"),  # axis title size and bold

    plot.title = element_text(hjust=0,size=14,face="bold"),  # title right-aligned, large, bold
    plot.caption = element_text(hjust = 0, face = "italic") # legenda alinhado à direita e itálico
    )+

  # rótulos de gráfico
  labs(x = "Week",
       y = "Facility name",
       fill = "Reporting\nperformance (%)",           # legend title, because legend shows fill
       title = "Percent of days per week that facility reported data",
       subtitle = "District health facilities, May-July 2020",
       caption = "7-day weeks beginning on Mondays.")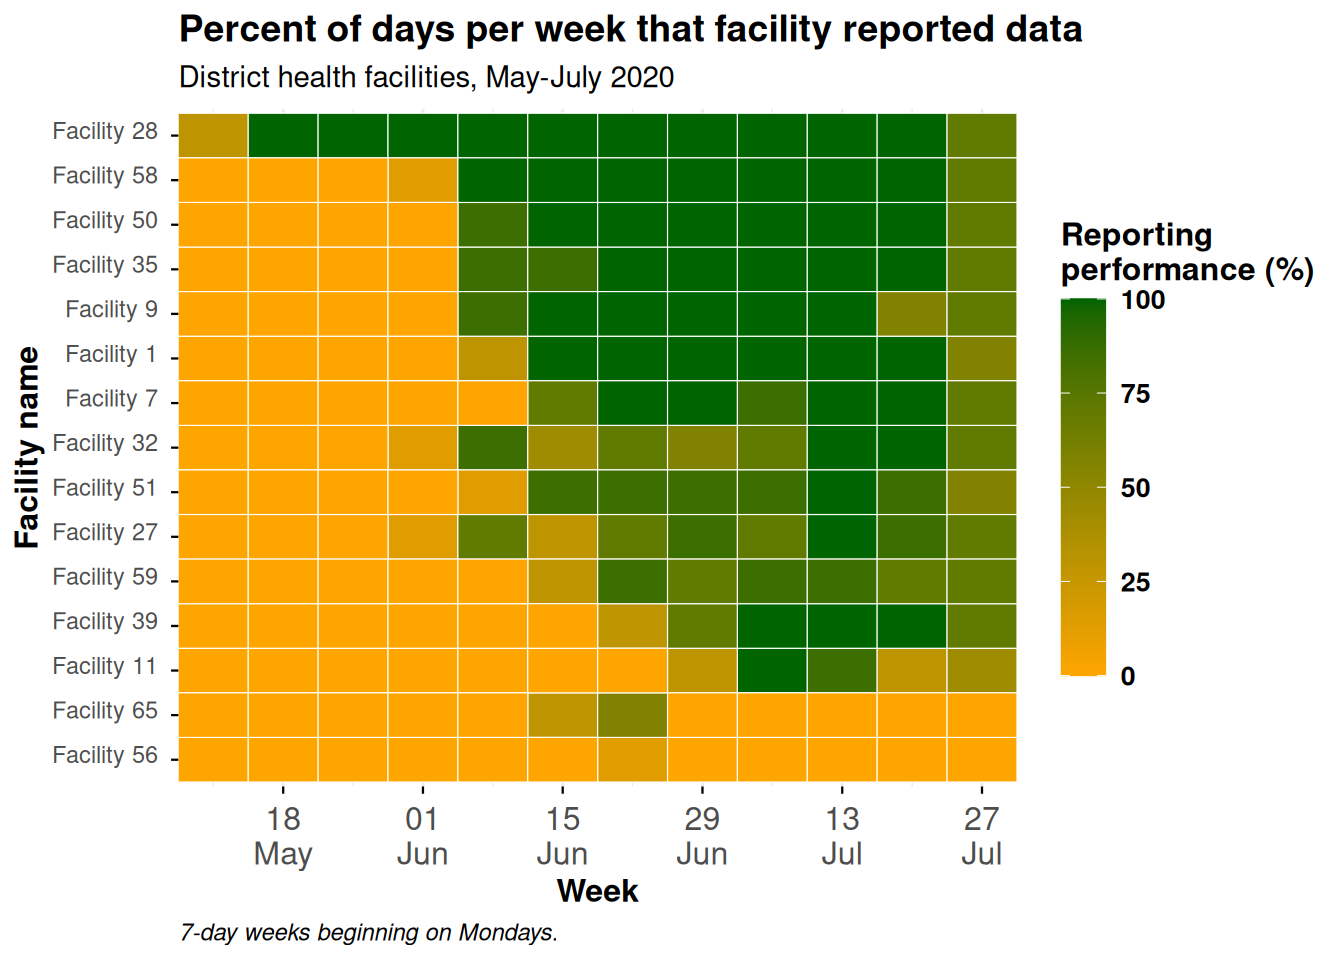
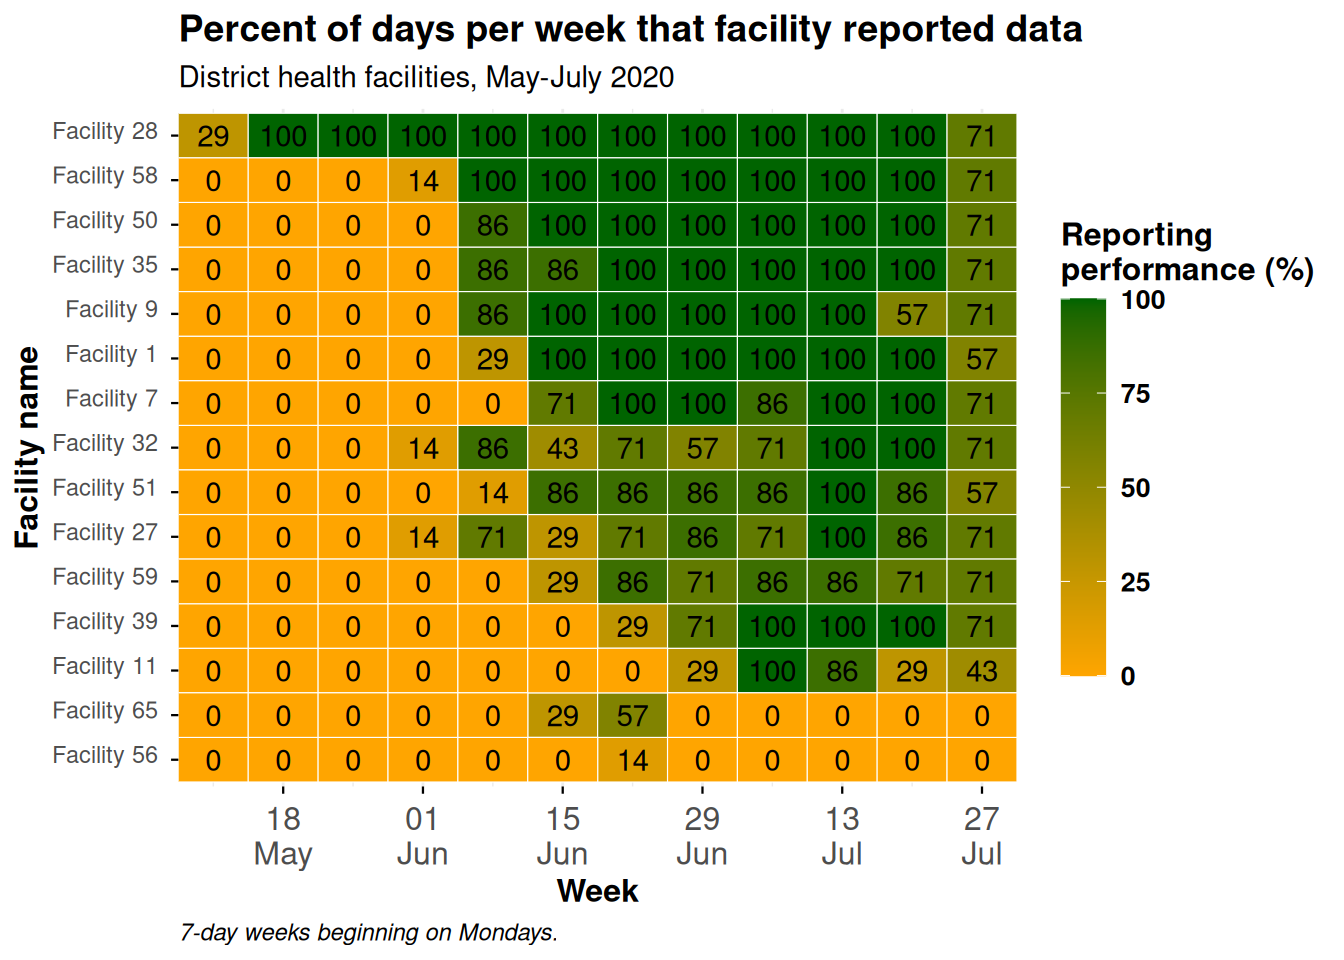
Você pode adicionar uma camada geom_text() no topo dos quadrados, para exibir os números reais de cada quadrado. Esteja ciente de que isso pode não parecer muito elegante se você tiver muitos quadradinhos pequenos!
O seguinte código foi adicionado: geom_text(aes(label = p_days_reported)). Isso adiciona texto a cada bloco. O texto exibido é o valor atribuído ao argumento label =, que neste caso foi definido para a mesma coluna numérica p_days_reported que também é usada para criar o gradiente de cor.
ggplot(data = agg_weeks)+

  # mostrar dados como quadrados
  geom_tile(
    aes(x = week,
        y = location_name,
        fill = p_days_reported),
    color = "white")+                 # white gridlines

  # texto
  geom_text(
    aes(
      x = week,
      y = location_name,
      label = p_days_reported))+      # add text on top of tile

  # escala de preenchimento
  scale_fill_gradient(
    low = "orange",
    high = "darkgreen",
    na.value = "grey80")+

  # eixo de data
  scale_x_date(
    expand = c(0,0), # remove espaço extra nas laterais
    date_breaks = "2 weeks", # rótulos a cada 2 semanas
    date_labels = "%d\n%b")+     # format is day over month (\n in newline)

  # temas estéticos
  theme_minimal()+                                    # simplify background

  theme(
    legend.title = element_text(size=12, face="bold"),
    legend.text  = element_text(size=10, face="bold"),
    legend.key.height = grid::unit(1,"cm"),           # height of legend key
    legend.key.width  = grid::unit(0.6,"cm"),         # width of legend key

    axis.text.x = element_text(size=12),              # axis text size
    axis.text.y = element_text(vjust=0.2),            # axis text alignment
    axis.ticks = element_line(linewidth=0.4),
    axis.title = element_text(size=12, face="bold"),  # axis title size and bold

    plot.title = element_text(hjust=0,size=14,face="bold"),  # title right-aligned, large, bold
    plot.caption = element_text(hjust = 0, face = "italic") # legenda alinhado à direita e itálico
    )+

  # rótulos de gráfico
  labs(x = "Week",
       y = "Facility name",
       fill = "Reporting\nperformance (%)",           # legend title, because legend shows fill
       title = "Percent of days per week that facility reported data",
       subtitle = "District health facilities, May-July 2020",
       caption = "7-day weeks beginning on Mondays.")