24 Salgın Modelleme
24.1 Genel Bakış
Salgın modelleme için, oldukça karmaşık analizleri minimum çabayla yapmamızı sağlayan, büyüyen bir araç grubu vardır. Bu bölüm, bu araçların aşağıdaki amaçlarla nasıl kullanılacağına ilişkin bir genel bakış sağlayacaktır:
- etkin üreme sayısı Rt ve iki katına çıkma süresi gibi ilgili istatistikleri tahmin etme
- gelecekteki insidansın kısa vadeli projeksiyonlarını üretme
Bu bölüm araçların altında yatan metodolojilere ve istatistiksel yöntemlere genel bir bakış değildir, bu nedenle bu konuyu kapsayan bazı makalelere bağlantılar için lütfen Kaynaklar sekmesine bakınız. Bu araçları kullanmadan önce yöntemleri anladığınızdan emin olun; bu, sonuçlarını doğru bir şekilde yorumlayabilmenizi sağlayacaktır.
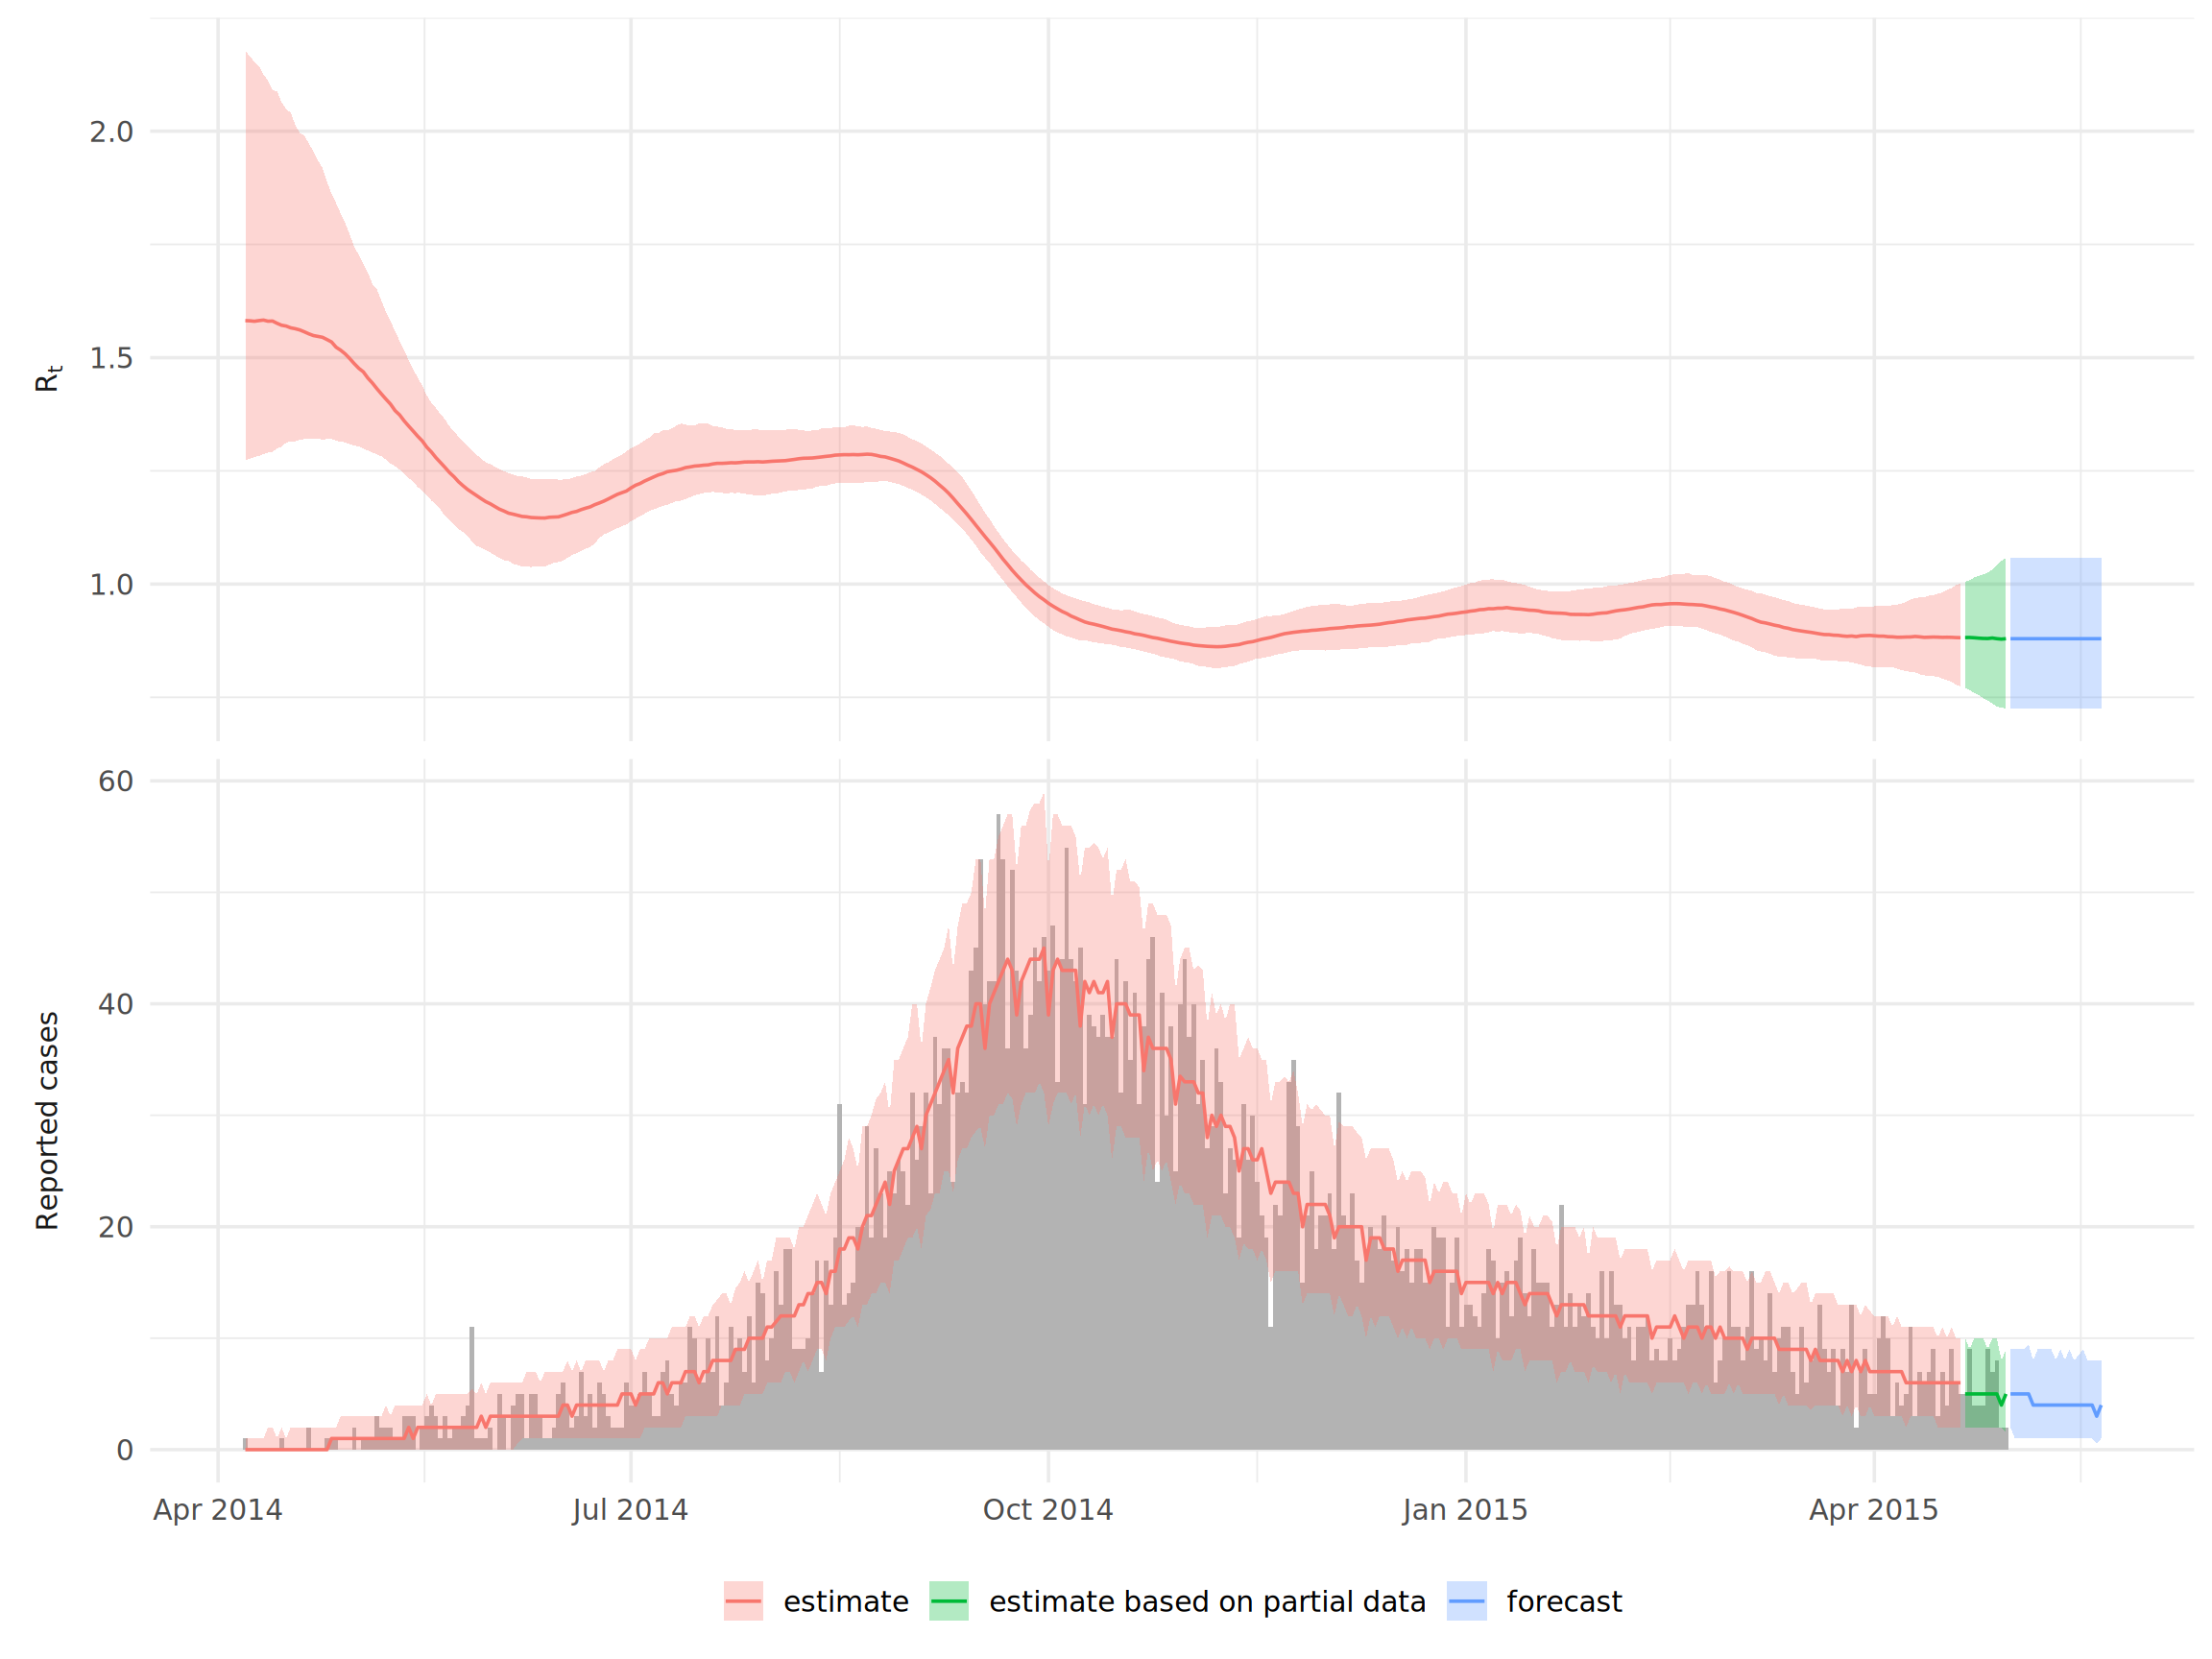
Aşağıda, bu bölümde üreteceğimiz çıktılardan birine bir örnek verilmiştir.
24.2 Hazırlık
Rt tahmini için EpiNow ve EpiEstim olmak üzere iki farklı yöntem ve paketin yanı sıra vaka insidansını tahmin etmek için projections paketini kullanacağız.
Bu kod parçası, analizler için gereken paketlerin yüklenmesini gösterir. Bu el kitabında, gerekirse paketi kuran ve kullanım için yükleyen pacman’dan p_load() vurgusunu yapıyoruz. base R’dan library() ile kurulu paketleri de yükleyebilirsiniz. R paketleri hakkında daha fazla bilgi için [R basics] sayfasına bakın.
pacman::p_load(
   rio,          # dosya içe aktarma
   here,         # dosya konumlama
   tidyverse,    # Veri yönetimi + ggplot2 grafikleri
   epicontacts,  # bulaş ağlarının analizi
   EpiNow2,      # Rt tahminleme
   EpiEstim,     # Rt tahminleme
   projections,  # İnsidans öngörme
   incidence2,   # İnsidans verilerini işleme
   incidence,    # Projeksiyonlar için incidence nesneleri
   epitrix,      # Faydalı epi fonksiyonları
   distcrete     # Ayrık gecikme dağılımları
)
Bu bölümdeki tüm analizler için temizlenmiş vaka satır listesini kullanacağız. Takip etmek isterseniz, “clean” dosyasını indirmek için tıklayın. ” (.rds dosyası olarak). Bu el kitabında kullanılan tüm örnek verileri indirmek için [El kitabı ve verileri indir] sayfasına bakınız.
# temizlenmiş satır listesini içe aktarma
linelist <- import("linelist_cleaned.rds")
24.3 Rt Tahmini
EpiNow2 vs. EpiEstim
Üreme sayısı R, bir hastalığın bulaşıcılığının bir ölçüsüdür ve enfekte vaka başına beklenen ikincil vaka sayısı olarak tanımlanır. Tamamen duyarlı bir popülasyonda bu değer, R0 (Rnought) temel üreme sayısını temsil eder. Bununla birlikte, bir salgın veya pandemi sırasında bir popülasyondaki duyarlı bireylerin sayısı değiştikçe ve çeşitli müdahale önlemleri uygulandıkça, en yaygın olarak kullanılan ölçüm aktarılabilirlik, etkili üreme sayısıdır Rt; bu, belirli bir t zamanında virüslü vaka başına beklenen ikincil vaka sayısı olarak tanımlanır.
EpiNow2 paketi, Rt tahmini için en gelişmiş çerçeveyi sağlar. Diğer yaygın olarak kullanılan paket olan EpiEstim’e göre iki önemli avantajı vardır:
- Raporlamadaki gecikmeleri hesaba katar ve bu nedenle son veriler eksik olsa bile Rt tahminini yapabilir.
- Rt’yi raporlamanın başlangıç tarihlerinden ziyade enfeksiyon tarihlerinde tahmin eder; bu, bir müdahalenin etkisinin Rt’deki bir değişikliğe gecikme ile değil hemen yansıtılacağı anlamına gelir.
Bununla birlikte, aynı zamanda iki önemli dezavantajı vardır:
- Bulaş süresi dağılımı (yani birincil ve ikincil vakaların enfeksiyonu arasındaki gecikmelerin dağılımı), kuluçka dönemi dağılımı (yani enfeksiyon ve semptom başlangıcı arasındaki gecikmelerin dağılımı) ve verilerinizle ilgili herhangi bir başka gecikme dağılımı (ör. raporlama tarihleriniz varsa, semptomların başlangıcından raporlamaya kadar olan gecikmelerin dağılımına ihtiyaç duyarsınız). Bu, Rt’nin daha doğru bir şekilde tahmin edilmesini sağlayacak olsa da, EpiEstim yalnızca seri aralık dağılımını (yani, birincil ve ikincil vakanın semptom başlangıcı arasındaki gecikmelerin dağılımına) ihtiyaç duyar. Elinizdeki tek veri bu olduğunda çok kıymetlidir.
EpiNow2, EpiEstim’den önemli ölçüde daha yavaştır, anekdot olarak yaklaşık 100-1000 kat! Örneğin, bu bölümde ele alınan örnek salgın için Rt tahmini yaklaşık dört saat sürer (bu, yüksek doğruluk sağlamak için çok sayıda yineleme için çalıştırılmasındandır. Gerekirse muhtemelen azaltılabilir, ancak ifade edilmek istenen algoritmanın genel olarak yavaş çalıştığıdır). Rt tahminlerinizi düzenli olarak güncelliyorsanız, kullanışlı olmayabilir.
Bu nedenle hangi paketi kullanmayı seçeceğiniz, size sunulan verilere, zamana ve hesaplama kaynaklarına bağlı olacaktır.
EpiNow2
Tahmini gecikme dağılımları
EpiNow2’yi çalıştırmak için gereken gecikme dağılımları, sahip olduğunuz verilere bağlıdır. Esasen, Rt tahmininde kullanmak istediğiniz bulaşma tarihinden olay tarihine kadar olan gecikmeyi tanımlayabilmeniz gerekir. Başlangıç tarihlerini kullanıyorsanız, bu sadece kuluçka dönemi dağılımı olacaktır. Raporlama tarihlerini kullanıyorsanız, enfeksiyondan raporlamaya kadar olan gecikmeye ihtiyacınız vardır. Bu dağıtımın doğrudan bilinmesi pek mümkün olmadığından, EpiNow2 birden çok gecikme dağıtımını birlikte zincirlemenize olanak tanır. Bu durumda, enfeksiyondan semptom başlangıcına (örneğin, muhtemelen bilinen kuluçka dönemi) ve semptom başlangıcından raporlamaya (genellikle verilerden tahmin edebileceğiniz) gecikmeyi bilmelisiniz.
Örnek satır listesindeki tüm vakalarımız için başlangıç tarihlerine sahip olduğumuzdan, verilerimizi (örn. semptom başlangıç tarihleri) enfeksiyon tarihine bağlamak için yalnızca kuluçka dönemi dağılımına ihtiyaç duyacağız. Bu dağılımı verilerden tahmin edebilir veya literatürdeki değerleri kullanabiliriz.
Ebola’nın kuluçka dönemine ilişkin bir literatür tahmini (bu makaleden alınmıştır) ortalama 9.1, standart sapma 7.3 ve maksimum değer 30 aşağıdaki gibi belirtilecektir:
incubation_period_lit <- LogNormal(
  mean = 9.1,
  sd = 7.3,
  max = 30
)
LogNormal() ortalamayı ve standart sapmayı gün olarak, doğal ölçekte alır ve bunları kendisi log ölçeğine çevirir. max parametresi dağılımı 30 günde keser.
Bu analizde, kuluçka dönemi dağılımını tahmin etmemiz gibi değil, satır listesinde enfeksiyon ve başlangıç arasında gözlemlenen gecikmelere uyacak bir lognormal dağılımı ‘bootstrapped_dist_fit’ fonksiyonu ile tahminliyoruz.
## inkübasyon süresini tahminleme
incubation_period <- bootstrapped_dist_fit(
  linelist$date_onset - linelist$date_infection,
  dist = "lognormal",
  max_value = 100,
  bootstraps = 1
)
İhtiyacımız olan diğer dağılım ise üreme süresidir. Bulaşma zamanları ve iletim bağlantılarına ilişkin verilerimiz olduğundan, bu dağılımı, bulaşan-bulaşan çiftlerinin bulaşma süreleri arasındaki gecikmeyi hesaplayarak satır listesinden tahmin edebiliriz. Bunu yapmak için, epicontacts paketindeki kullanışlı get_pairwise fonksiyonunu kullanıyoruz. Bu, iletim çiftleri arasındaki satır listesi özelliklerinin ikili farklılıklarını hesaplamamıza izin veriyor. Önce bir epicontacts nesnesi oluşturuyoruz (daha fazla ayrıntı için [İletim zincirleri] sayfasına bakabilirsiniz):
## kişileri oluştur
contacts <- linelist %>%
  transmute(
    from = infector,
    to = case_id
  ) %>%
  drop_na()

## temaslı kişileri oluştur
epic <- make_epicontacts(
  linelist = linelist,
  contacts = contacts,
  directed = TRUE
)
Daha sonra, “get_pairwise” kullanılarak hesaplanan iletim çiftleri arasındaki enfeksiyon sürelerindeki farkı bir gama dağılımına uydururuz:
## gama oluşturma süresini tahmin et
generation_time <- bootstrapped_dist_fit(
  get_pairwise(epic, "date_infection"),
  dist = "gamma",
  max_value = 20,
  bootstraps = 1
)
EpiNow2 Çalıştırmak
Şimdi sadece dplyr group_by() ve n() fonskiyonlarıyla kolayca yapabileceğimiz satır listesinden günlük insidansı hesaplamamız gerekiyor. EpiNow2 sütun adlarının “date” ve “confirm” olmasını gerektirdiğini unutmayın. EpiNow2 eksik bir tarihte de hatayla durur, bu nedenle başlangıç tarihi olmayan vakaları çıkarıyoruz. Tarihler arasında boşluklar olduğunda EpiNow2 1.9.0 bu verilerde hatayla durdu. Bu nedenle fill_missing() vaka olmayan günleri 0 sayısıyla ekler.
## başlangıç tarihlerinden insidans almak
cases <- linelist %>%
  filter(!is.na(date_onset)) %>%
  group_by(date = date_onset) %>%
  summarise(confirm = n()) %>%
  ## vaka olmayan günleri 0 sayısıyla ekleyin
  fill_missing(missing_dates = "zero")
Daha sonra ‘epinow’ fonksiyonunu kullanarak Rt değerini tahmin edebiliriz. Girişlerle ilgili bazı notlar:
-
generation_timedeğişkeni, jenerasyon süresi dağılımınıgt_optsfonksiyonu içinde alır. - ‘delays’ değişkenine herhangi bir sayıda ‘zincirleme’ gecikme dağılımı sağlayabiliriz; onları sadece ‘delay_opts’ işlevi içinde
+ile ‘incubation_period’ nesnesine ekleyebiliriz. -
forecast_optsfonksiyonundakihorizon, gelecekteki insidansı kaç gün için tahmin etmek istediğimizi gösterir. - Çıkarımı ne kadar süreyle çalıştırmak istediğimizi belirtmek için ‘stan’ değişkenine ek seçenekler iletiyoruz. Artan “örnekler” ve “zincirler”, belirsizliği daha iyi karakterize eden daha doğru bir tahmin verecektir, ancak çalışması daha uzun sürecektir..
## epinow çalıştır
epinow_res <- epinow(
  data = cases,
  generation_time = gt_opts(generation_time),
  delays = delay_opts(incubation_period),
  forecast = forecast_opts(horizon = 21),
  stan = stan_opts(samples = 750, chains = 4)
)
Çıktıları analiz etme
Bu sayfa modeli çalıştırmaz. Aşağıdaki sonuçlar, appliedepidata paketinde kaydedilmiş bir modelden gelir. Bu modeli EpiNow2’nin daha eski bir sürümü oluşturdu. Yukarıdaki kod, böyle bir modeli EpiNow2 1.9 ile oluşturmanın yoludur.
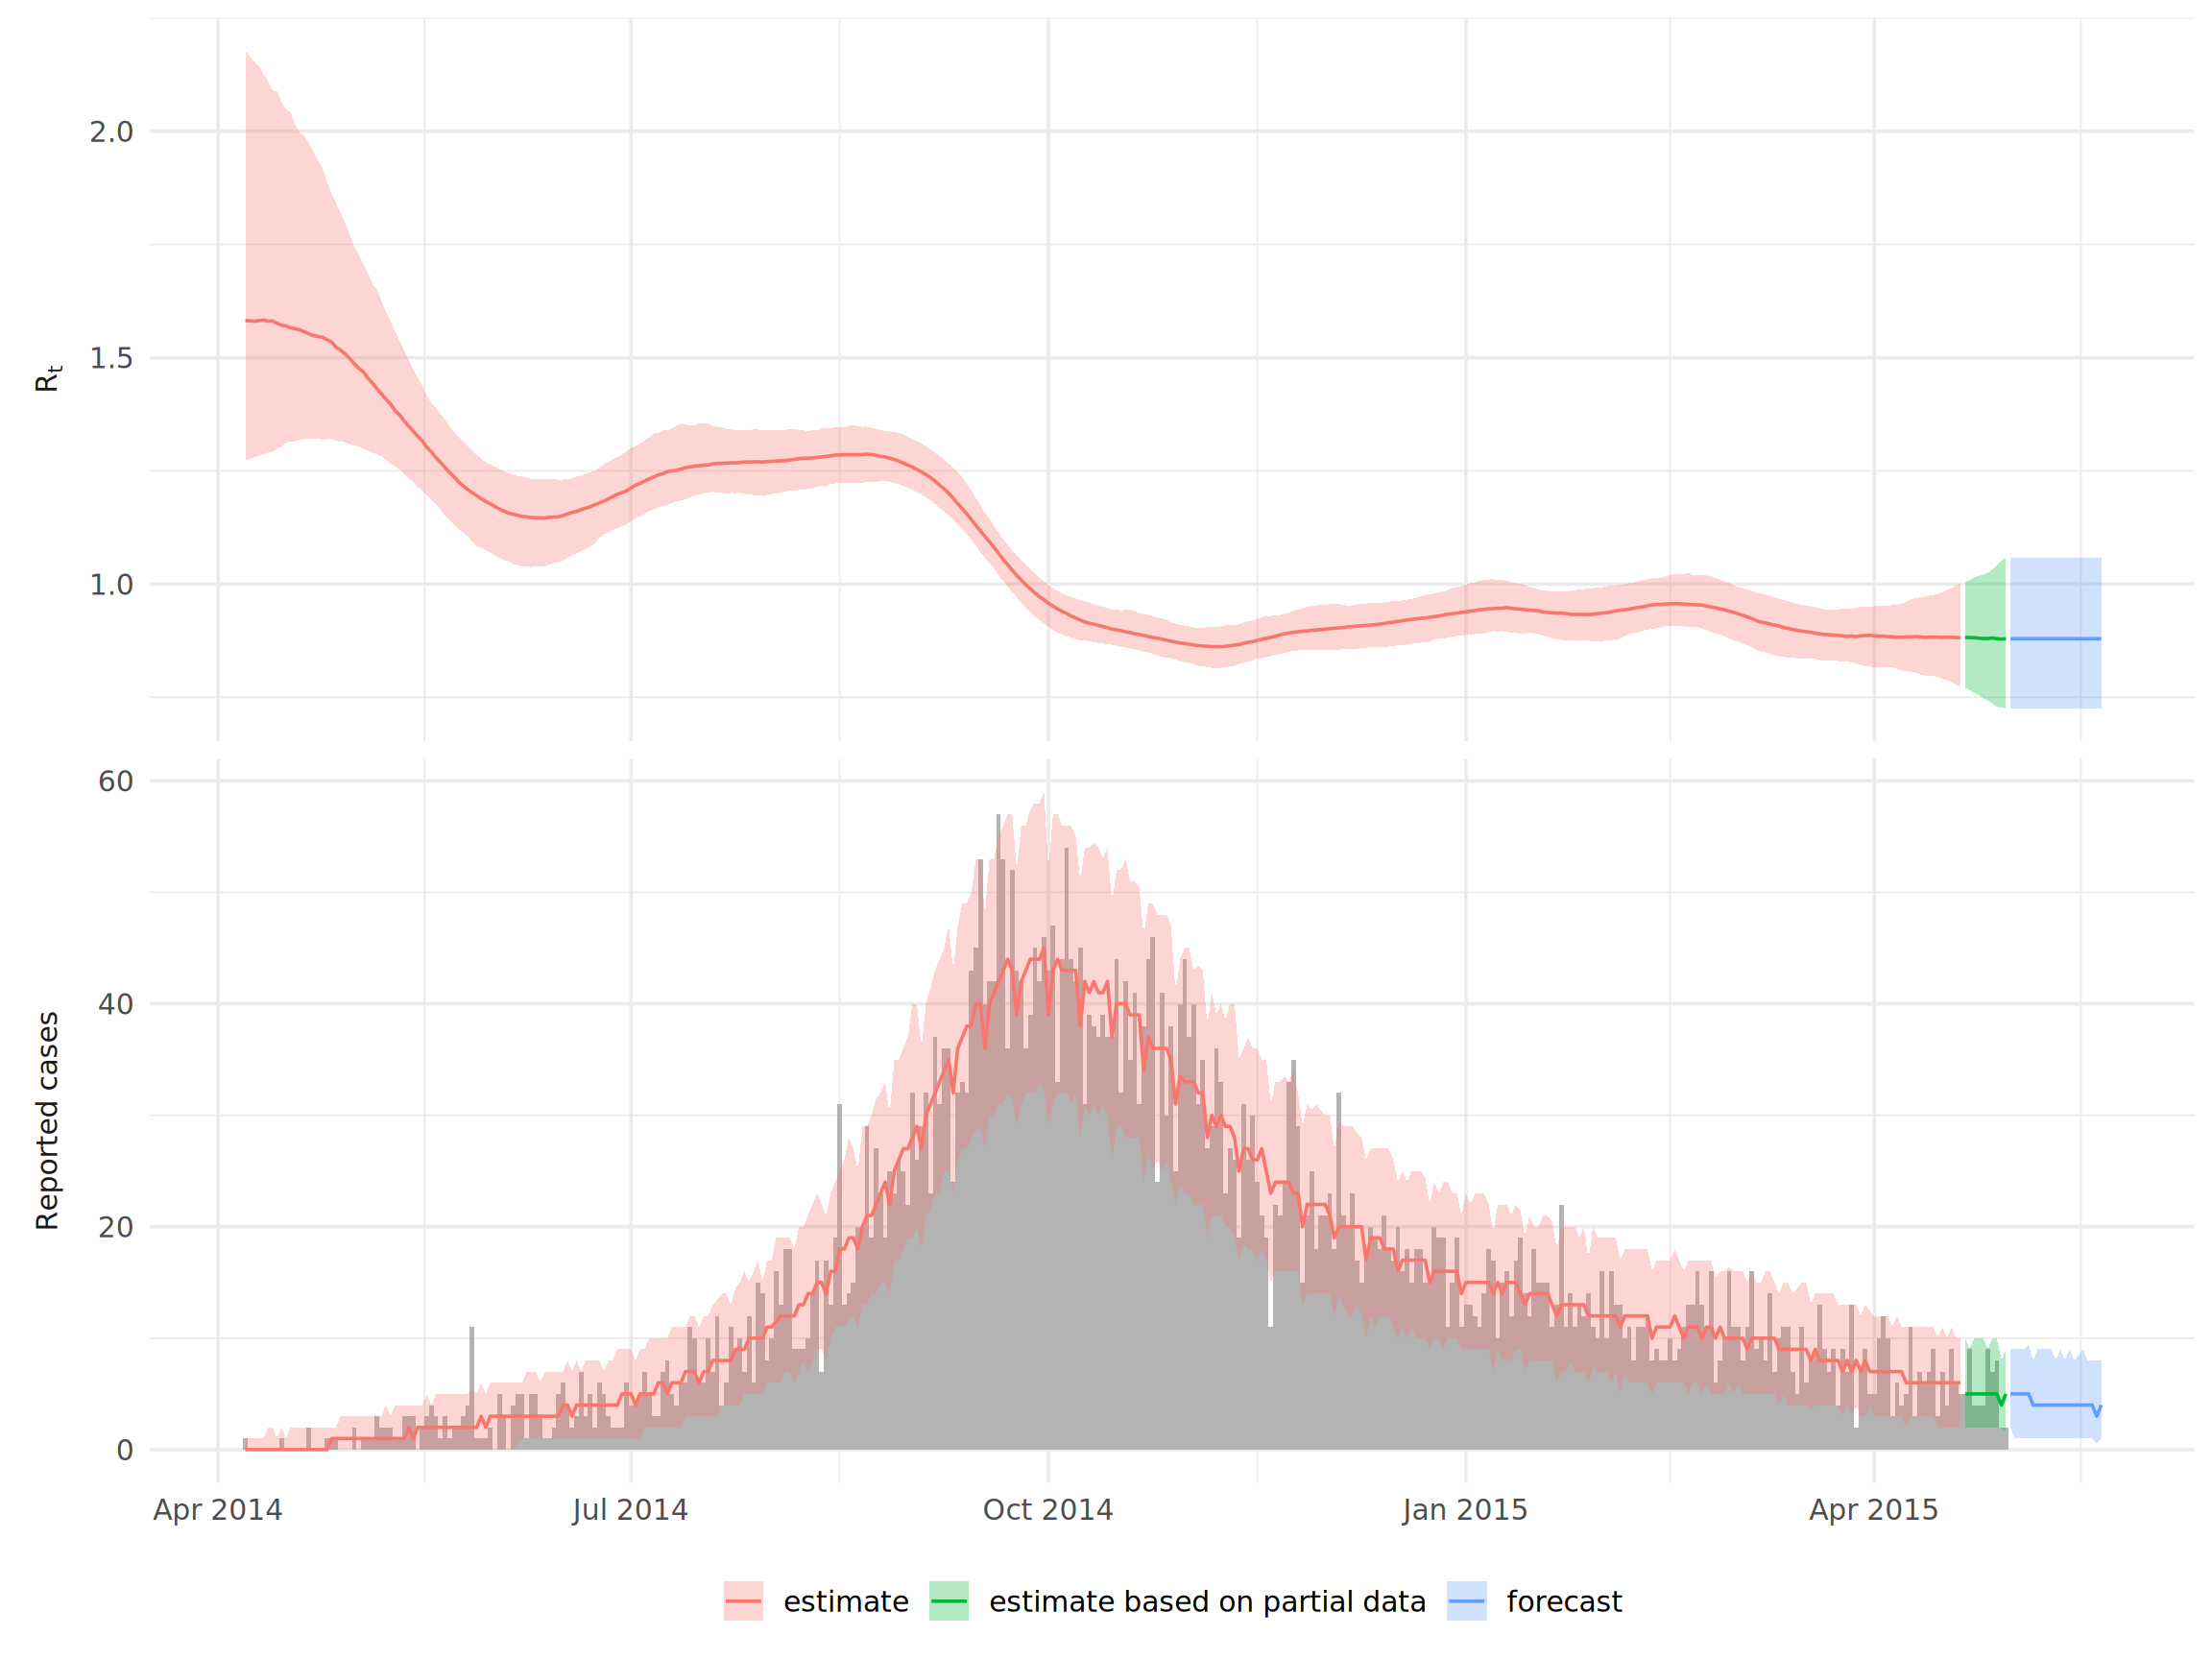
EpiNow2 1.9 ile oluşturulan bir modelde plot() fonksiyonu bir özet şekil çizer ve summary() fonksiyonu bir özet tablo verir. Bu fonksiyonlar kaydedilmiş modelde hatayla durur. Bu nedenle kaydedilmiş modelin tablolarını yüklüyor ve ggplot2 ile çiziyoruz:
## kaydedilmiş tahminleri ve modelin kullandığı vaka sayılarını yükleyin
estimates <- appliedepidata::get_data(name = "epidemic_models_summarised_estimates")
observations <- appliedepidata::get_data(name = "epidemic_models_reported_cases")

## özet grafiği çiz
ggplot(
  data = filter(estimates, variable %in% c("R", "reported_cases")),
  aes(x = date)
) +
  ## gözlenen vaka sayıları, yalnızca bildirilen vakalar panelinde
  geom_col(
    data = mutate(observations, variable = "reported_cases"),
    aes(y = confirm),
    fill = "grey70",
    width = 1
  ) +
  ## %90 güvenilir aralık ve medyan, tahmin türüne göre renklendirilmiş
  geom_ribbon(aes(ymin = lower_90, ymax = upper_90, fill = type), alpha = 0.3) +
  geom_line(aes(y = median, colour = type)) +
  ## alt simge etiketine izin vermek için label_parsed kullanın
  facet_wrap(
    ~ variable,
    ncol = 1,
    scales = "free_y",
    labeller = as_labeller(c("R" = "R[t]", "reported_cases" = "Reported~cases"), label_parsed),
    strip.position = 'left'
  ) +
  labs(x = NULL, y = NULL, colour = NULL, fill = NULL) +
  theme_minimal(base_size = 14) +
  theme(
    strip.background = element_blank(),
    strip.placement = 'outside',
    legend.position = 'bottom'
  )
Ayrıca çeşitli özet istatistiklere de bakabiliriz:
## kaydedilmiş modelin özet tablosu
summary_table <- appliedepidata::get_data(name = "epidemic_models_summary")
summary_table[, c("measure", "estimate")]
measure estimate
1 New confirmed cases by infection date 4 (2 -- 6)
2 Expected change in daily cases Unsure
3 Effective reproduction no. 0.88 (0.73 -- 1.1)
4 Rate of growth -0.012 (-0.028 -- 0.0052)
5 Doubling/halving time (days) -60 (130 -- -25)Daha fazla analiz ve özel çizim için, EpiNow2 1.9 ile oluşturulan bir modelin özetlenen günlük tahminlerine summary(epinow_res, type = "parameters") ile erişebilirsiniz. dplyr ile kullanım kolaylığı için bunu varsayılan ’veri.tablosu’ndan ’tibble’a çevireceğiz. Aşağıdaki tablo, kaydedilmiş modelin aynı tahminlerini gösterir.
## özeti çıkar ve tibble'a dönüştür
estimates <- as_tibble(summary(epinow_res, type = "parameters"))
estimates
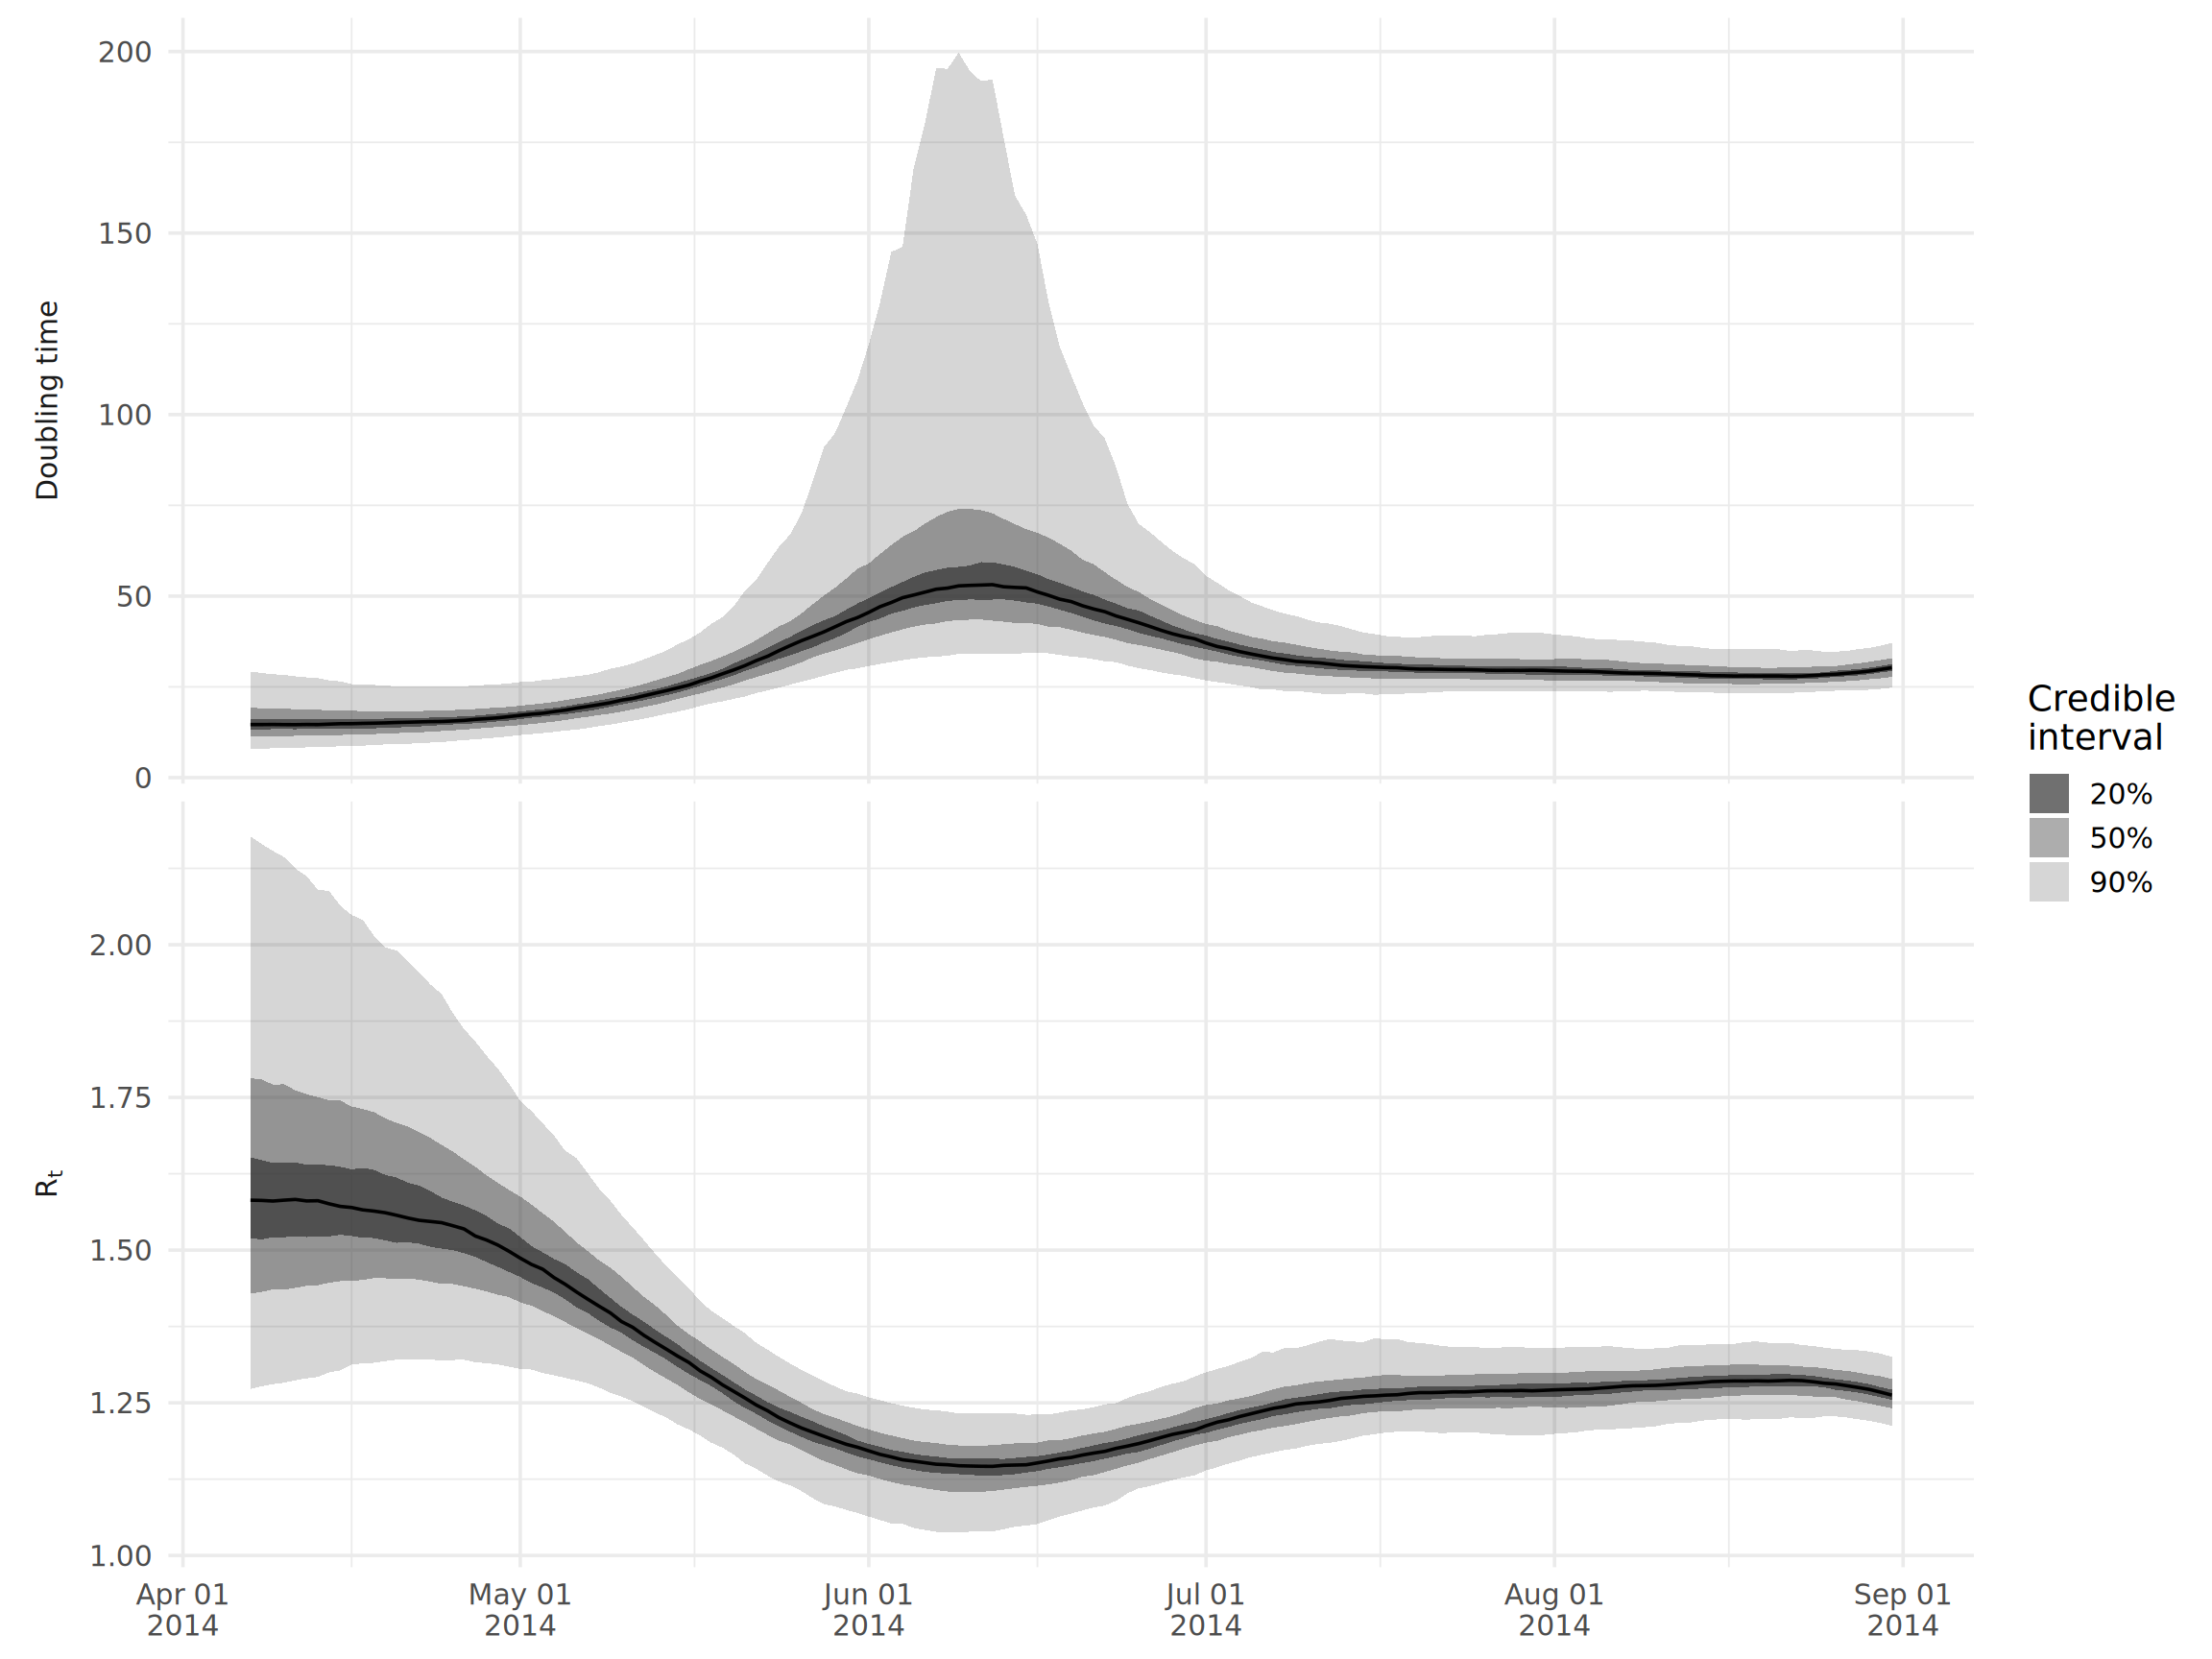
Örnek olarak, ikiye katlama süresinin ve Rt’nin bir grafiğini yapalım. Aşırı yüksek katlama zamanlarını planlamaktan kaçınmak için, Rt birin çok üzerinde olduğunda, salgının yalnızca ilk birkaç ayına bakacağız.
Tahmini büyüme oranından iki katına çıkma süresini hesaplamak için “log(2)/growth_rate” formülünü kullanırız.
## medyan çizim için geniş df yapın
df_wide <- estimates %>%
  filter(
    variable %in% c("growth_rate", "R"),
    date < as.Date("2014-09-01")
  ) %>%
  ## büyüme oranlarını ikiye katlama sürelerine dönüştürme
  mutate(
    across(
      c(median, lower_90:upper_90),
      ~ case_when(
        variable == "growth_rate" ~ log(2)/.x,
        TRUE ~ .x
      )
    ),
    ## dönüşümü yansıtmak için değişkeni yeniden adlandırın
    variable = replace(variable, variable == "growth_rate", "doubling_time")
  )

## nicel çizim için uzun df yapın
df_long <- df_wide %>%
  ## burada eşleşen nicelikleri eşleştiriyoruz (örneğin, alt_90 ila üst_90)
  pivot_longer(
    lower_90:upper_90,
    names_to = c(".value", "quantile"),
    names_pattern = "(.+)_(.+)"
  )

## grafik yapın
ggplot() +
  geom_ribbon(
    data = df_long,
    aes(x = date, ymin = lower, ymax = upper, alpha = quantile),
    color = NA
  ) +
  geom_line(
    data = df_wide,
    aes(x = date, y = median)
  ) +
  ## alt simge etiketine izin vermek için label_parsed kullanın
  facet_wrap(
    ~ variable,
    ncol = 1,
    scales = "free_y",
    labeller = as_labeller(c(R = "R[t]", doubling_time = "Doubling~time"), label_parsed),
    strip.position = 'left'
  ) +
  ## nicel şeffaflığı manuel olarak tanımla
  scale_alpha_manual(
    values = c(`20` = 0.7, `50` = 0.4, `90` = 0.2),
    labels = function(x) paste0(x, "%")
  ) +
  labs(
    x = NULL,
    y = NULL,
    alpha = "Credible\ninterval"
  ) +
  scale_x_date(
    date_breaks = "1 month",
    date_labels = "%b %d\n%Y"
  ) +
  theme_minimal(base_size = 14) +
  theme(
    strip.background = element_blank(),
    strip.placement = 'outside'
  )
EpiEstim
EpiEstim’i çalıştırmak için günlük insidans hakkında veri sağlamamız ve seri aralığı (yani semptomların başlangıcı arasındaki gecikmelerin dağılımını (birincil ve ikincil vakalar) belirtmemiz gerekir).
İnsidans verileri EpiEstim’e bir vektör, veri çerçevesi veya orijinal insidans paketinden bir “insidans” nesnesi olarak sağlanabilir. İçe aktamalar ve yerel olarak edinilen enfeksiyonlar arasında bile ayrım yapabilirsiniz. Daha fazla detay için ?estimate_R adresindeki belgelere bakabilirsiniz.
Girdiyi incidence2 kullanarak oluşturacağız. incidence2 paketiyle ilgili daha fazla örnek için [Salgın eğrileri] ile ilgili sayfaya bakabilirsiniz. incidence2 paketinde, “estimate_R()”nin beklenen girdisiyle tam olarak uyuşmayan güncellemeler olduğundan, gerekli bazı küçük ek adımlar vardır. İnsidans nesnesi, tarihlerin ve ilgili vaka sayılarının bulunduğu bir tibble’dan oluşur. Tüm tarihlerin dahil edildiğinden emin olmak için tidyr’den ‘complete()’ kullanırız. Daha sonra sonraki bir adımda ‘estimate_R()’ tarafından beklenenle hizalanacak şekilde sütunları ‘yeniden adlandırın()’.
## başlangıç tarihinden itibaren insidansı almak
cases <- incidence2::incidence(linelist, date_index = "date_onset") %>% # günlere göre vaka sayılarını al
  tidyr::complete(date_index = seq.Date(                              # tüm tarihlerin temsil edildiğinden emin olun
    from = min(date_index, na.rm = T),
    to = max(date_index, na.rm=T),
    by = "day"),
    fill = list(count = 0)) %>%                                       # NA sayılarını 0'a çevir
  rename(I = count,                                                   # estimate_R()'a göre beklenen adlarla yeniden adlandırın
         dates = date_index)
Paket, ayrıntıları “?estimate_R” adresindeki belgelerde sağlanan seri aralığı belirtmek için çeşitli seçenekler sunar. Biz burada bunlardan ikisini ele alacağız.
Literatürden seri aralık tahminlerini kullanma
method = "parametric_si" seçeneğini kullanarak, make_config fonksiyonu kullanılarak oluşturulan bir config nesnesindeki seri aralığın ortalamasını ve standart sapmasını manuel olarak belirtebiliriz. Bu belgede tanımlanan sırasıyla 12,0 ve 5,2’lik bir ortalama ve standart sapma kullanıyoruz.
Varsayılan olarak estimate_R(), verinin ikinci gününden başlayan haftalık kayan pencereler kullanır. EpiEstim, çok az vakadan tahmin edilen Rt’nin güvenilir olmadığı konusunda uyarır: varsayılan ayarlarıyla bir pencerede en az 11 vakaya ihtiyaç duyar. Bu salgının ilk haftalarında daha az vaka vardır. Bu nedenle haftalık pencereleri en az 11 vaka içeren ilk 7 günlük pencereden başlatıyor ve aşağıdaki iki tahmin için de bu pencereleri kullanıyoruz:
## günlük vaka sayıları, her gün için bir satır
daily_cases <- cases$I

## her gün başlayan 7 günlük penceredeki vaka sayısı
window_cases <- sapply(
  seq_len(length(daily_cases) - 6),
  function(t) sum(daily_cases[t:(t + 6)])
)

## en az 11 vaka içeren ilk pencereden başlayan haftalık kayan pencereler
weekly_start <- max(2, which(window_cases >= 11)[1]):(length(daily_cases) - 6)
weekly_end <- weekly_start + 6

## yapılandırma yap
config_lit <- make_config(
  mean_si = 12.0,
  std_si = 5.2,
  t_start = weekly_start,
  t_end = weekly_end
)
Daha sonra estimate_R fonksiyonuyla Rt değerini tahmin edebiliriz:
cases <- cases %>%
     filter(!is.na(dates))


#create a dataframe for the function estimate_R()
cases_incidence <- data.frame(dates = seq.Date(from = min(cases$dates),
                               to = max(cases$dates),
                               by = 1))

cases_incidence <- left_join(cases_incidence, cases, by = "dates") %>%
     select(dates, I) %>%
     mutate(I = ifelse(is.na(I), 0, I))

epiestim_res_lit <- estimate_R(
  incid = cases_incidence,
  method = "parametric_si",
  config = config_lit
)
ve Rt tahminlerini çizin. EpiEstim’in plot() fonksiyonu ggplot2’den bir kullanımdan kaldırma uyarısı verir, bu nedenle tahminleri ggplot2 ile çizen kısa bir fonksiyon yazıyoruz. Fonksiyon her tahmini zaman penceresinin son günüyle tarihlendirir:
## ortalama R tahminini ve %95 güvenilir aralığını çizin
plot_rt <- function(res) {
  res$R %>%
    ## tahmini olmayan zaman pencerelerini çıkarın
    filter(!is.na(`Mean(R)`)) %>%
    ## her tahmini, zaman penceresinin son günüyle tarihlendirin
    mutate(date = res$dates[t_end]) %>%
    ggplot(aes(x = date)) +
    geom_ribbon(aes(ymin = `Quantile.0.025(R)`, ymax = `Quantile.0.975(R)`), alpha = 0.3) +
    geom_line(aes(y = `Mean(R)`)) +
    geom_hline(yintercept = 1, linetype = 2) +
    labs(x = NULL, y = expression(R[t])) +
    theme_minimal(base_size = 14)
}

plot_rt(epiestim_res_lit)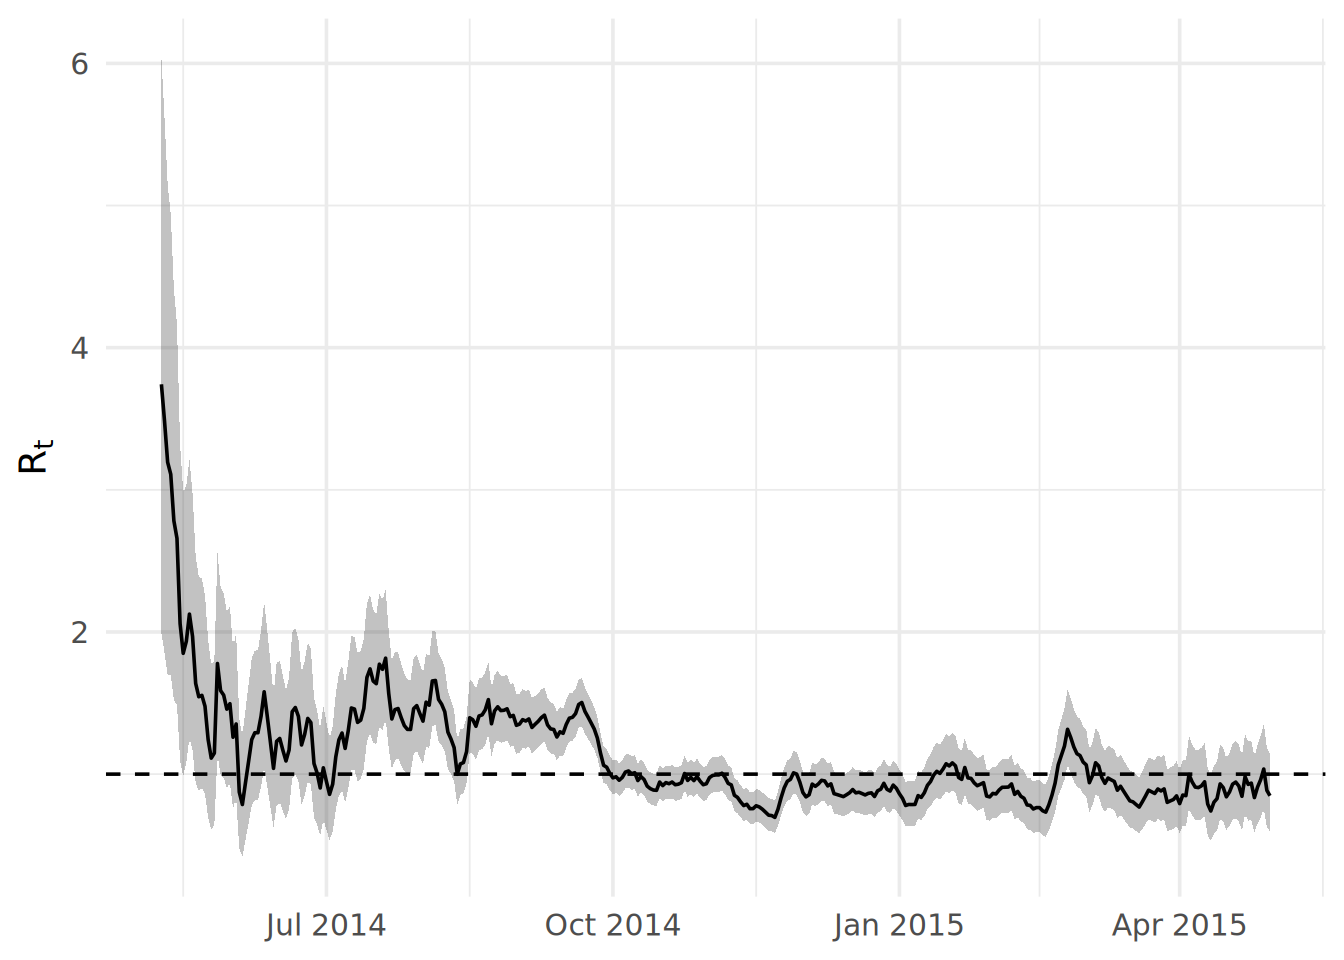
Verilerden seri aralık tahminlerini kullanma
Semptom başlangıç tarihlerine ve iletim bağlantılarına ilişkin verilere sahip olduğumuz için, bulaştırıcı-enfekte çiftlerinin başlangıç tarihleri arasındaki gecikmeyi hesaplayarak satır listesinden seri aralığı da tahmin edebiliriz. EpiNow2 bölümünde yaptığımız gibi, epicontacts paketindeki get_pairwise fonksiyonunu kullanacağız, bu da iletim çiftleri arasındaki satır listesi özelliklerinin ikili farklarını hesaplamamızı sağlar. Önce bir epicontacts nesnesi oluşturuyoruz (daha fazla ayrıntı için [İletim zincirleri] sayfasına bakın):
## kişileri oluştur
contacts <- linelist %>%
  transmute(
    from = infector,
    to = case_id
  ) %>%
  drop_na()

## temaslıları oluştur
epic <- make_epicontacts(
  linelist = linelist,
  contacts = contacts,
  directed = TRUE
)
Daha sonra, “get_pairwise” kullanılarak hesaplanan iletim çiftleri arasındaki başlangıç tarihlerindeki farkı bir gama dağılımına uydururuz. Bu yerleştirme prosedürü için epitrix paketindeki kullanışlı ’fit_disc_gamma’yı kullanıyoruz, çünkü bir ayrıştırılmış dağıtıma ihtiyacımız var.
## gama seri aralığını tahmin edin, başlangıç tarihi olmayan çiftler hariç
serial_interval <- fit_disc_gamma(na.omit(get_pairwise(epic, "date_onset")))
Daha sonra bu bilgiyi config nesnesine iletiyoruz, EpiEstim’i tekrar çalıştırıyoruz ve sonuçları çiziyoruz:
## yapılandırma yap
config_emp <- make_config(
  mean_si = serial_interval$mu,
  std_si = serial_interval$sd,
  t_start = weekly_start,
  t_end = weekly_end
)

## epiestim çalıştır
epiestim_res_emp <- estimate_R(
  incid = cases_incidence,
  method = "parametric_si",
  config = config_emp
)

## grafik çıktısı al
plot_rt(epiestim_res_emp)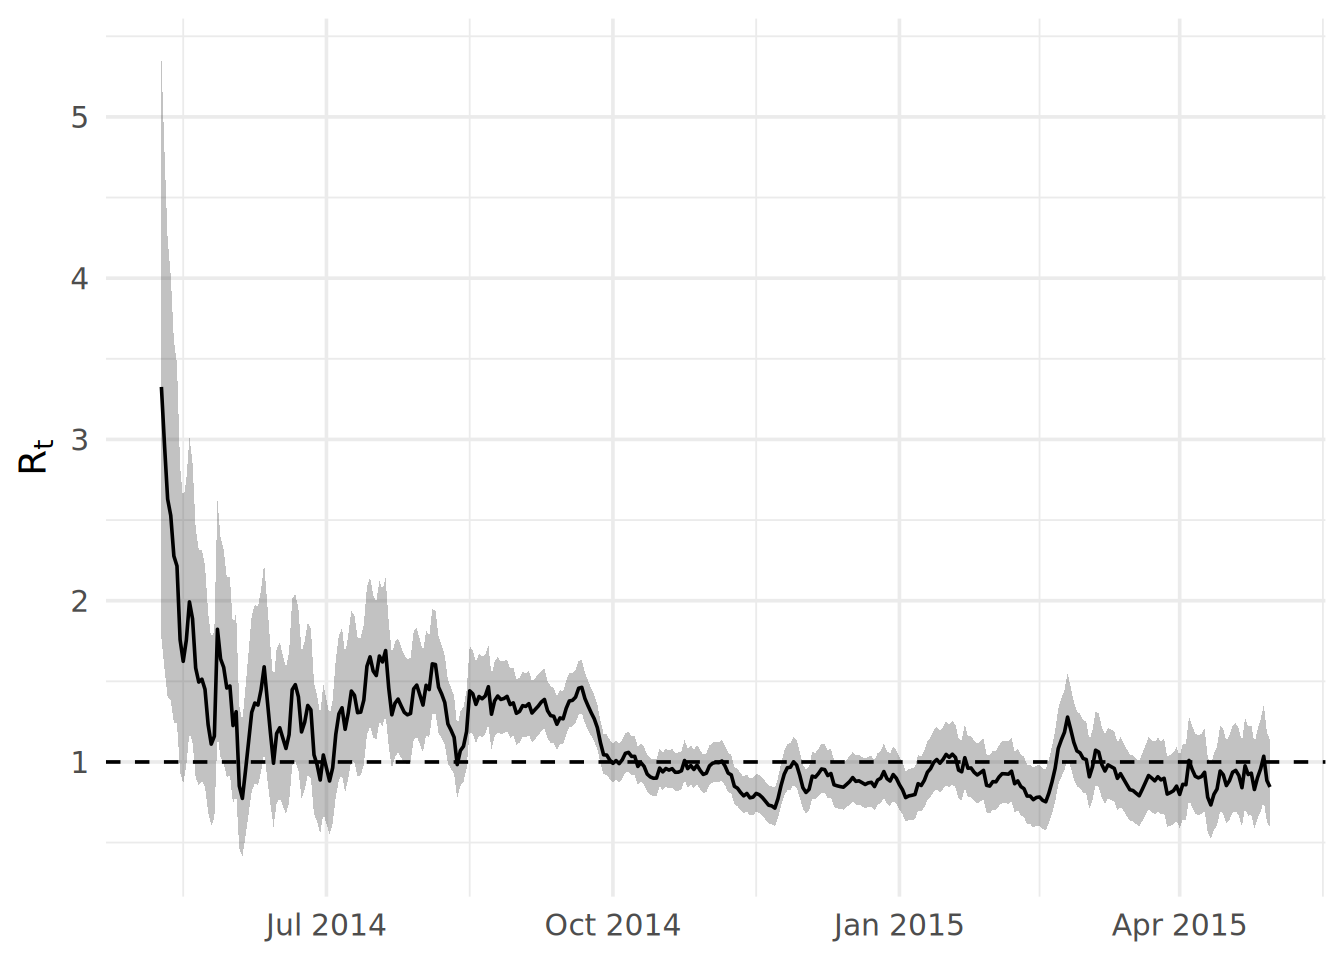
Tahmin zaman pencerelerini belirtme
Pencerelerin başlangıcını kendiniz de seçebilirsiniz; örneğin aşağıda gösterildiği gibi Rt’yi yalnızca 1 Haziran 2014’ten itibaren tahmin edebilirsiniz. Ne yazık ki, EpiEstim, her zaman penceresi için başlangıç ve bitiş tarihlerine atıfta bulunan bir tam sayı vektörü sağlamanız gerektiğinden, bu tahmin sürelerini belirtmek için yalnızca çok hantal bir yol sağlar.
## 1 Haziran'da başlayan bir tarih vektörü tanımlayın
start_dates <- seq.Date(
  as.Date("2014-06-01"),
  max(cases$dates) - 7,
  by = 1
) %>%
  ## sayısala dönüştürmek için başlangıç tarihini çıkarın
  `-`(min(cases$dates)) %>%
  ## tam sayıya çevirin
  as.integer() %>%
  ## 1 ekleyin, çünkü insidans verisinin 1. günü ilk tarihidir
  `+`(1L)

## bir haftalık sürgülü pencere protokolüne altı gün ekleyin
end_dates <- start_dates + 6

## yapılandırma yap
config_partial <- make_config(
  mean_si = 12.0,
  std_si = 5.2,
  t_start = start_dates,
  t_end = end_dates
)
Şimdi EpiEstim’i yeniden çalıştırıyoruz ve tahminlerin yalnızca Haziran’dan itibaren başladığını görebiliyoruz:
## epiestim'i çalıştır
epiestim_res_partial <- estimate_R(
  incid = cases_incidence,
  method = "parametric_si",
  config = config_partial
)

## çıktıları grafikleştir
plot_rt(epiestim_res_partial)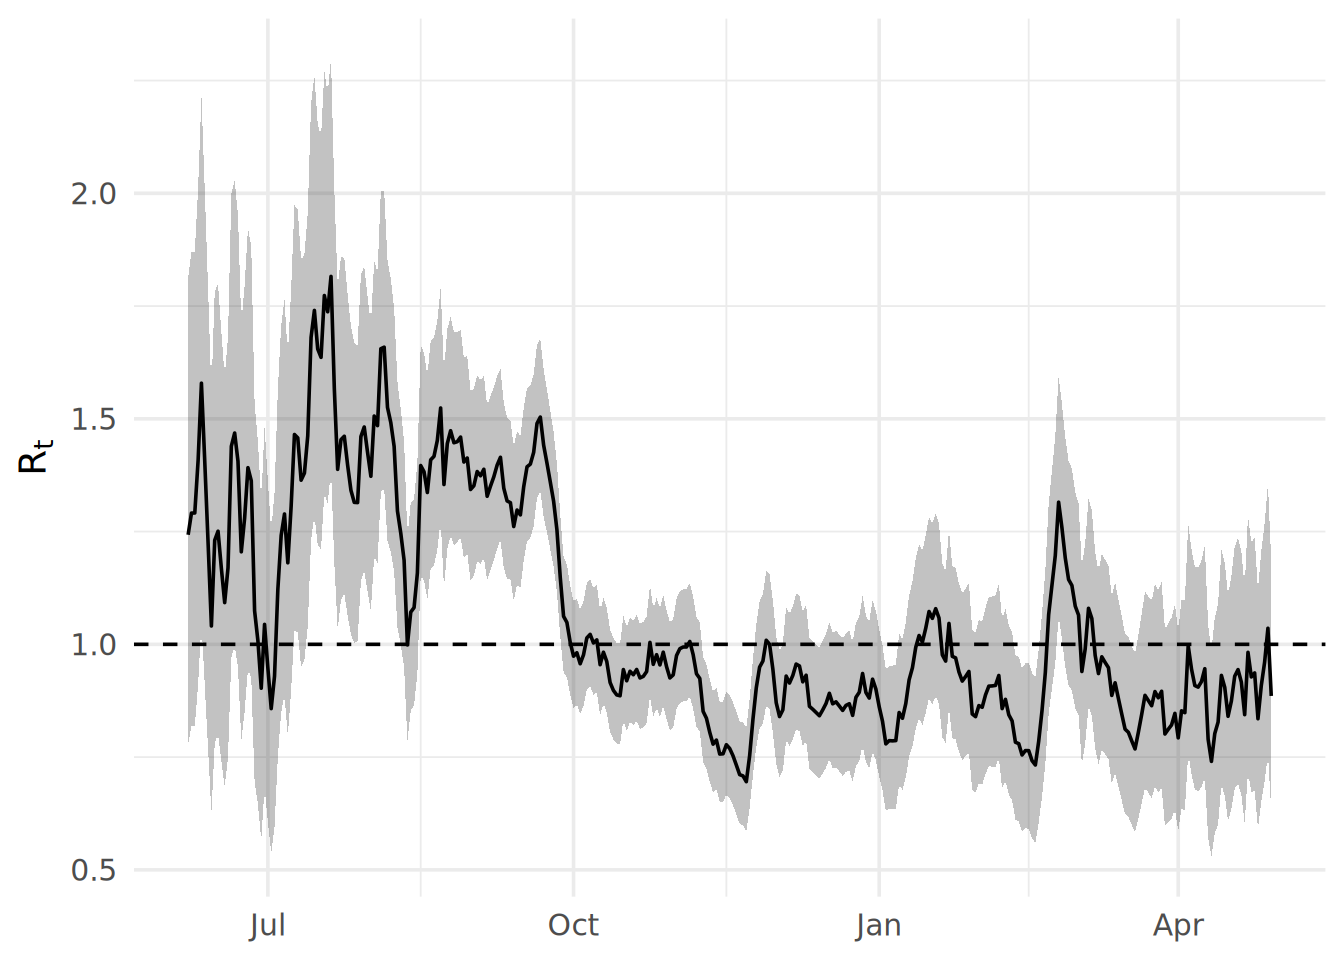
Çıktıları analiz etme
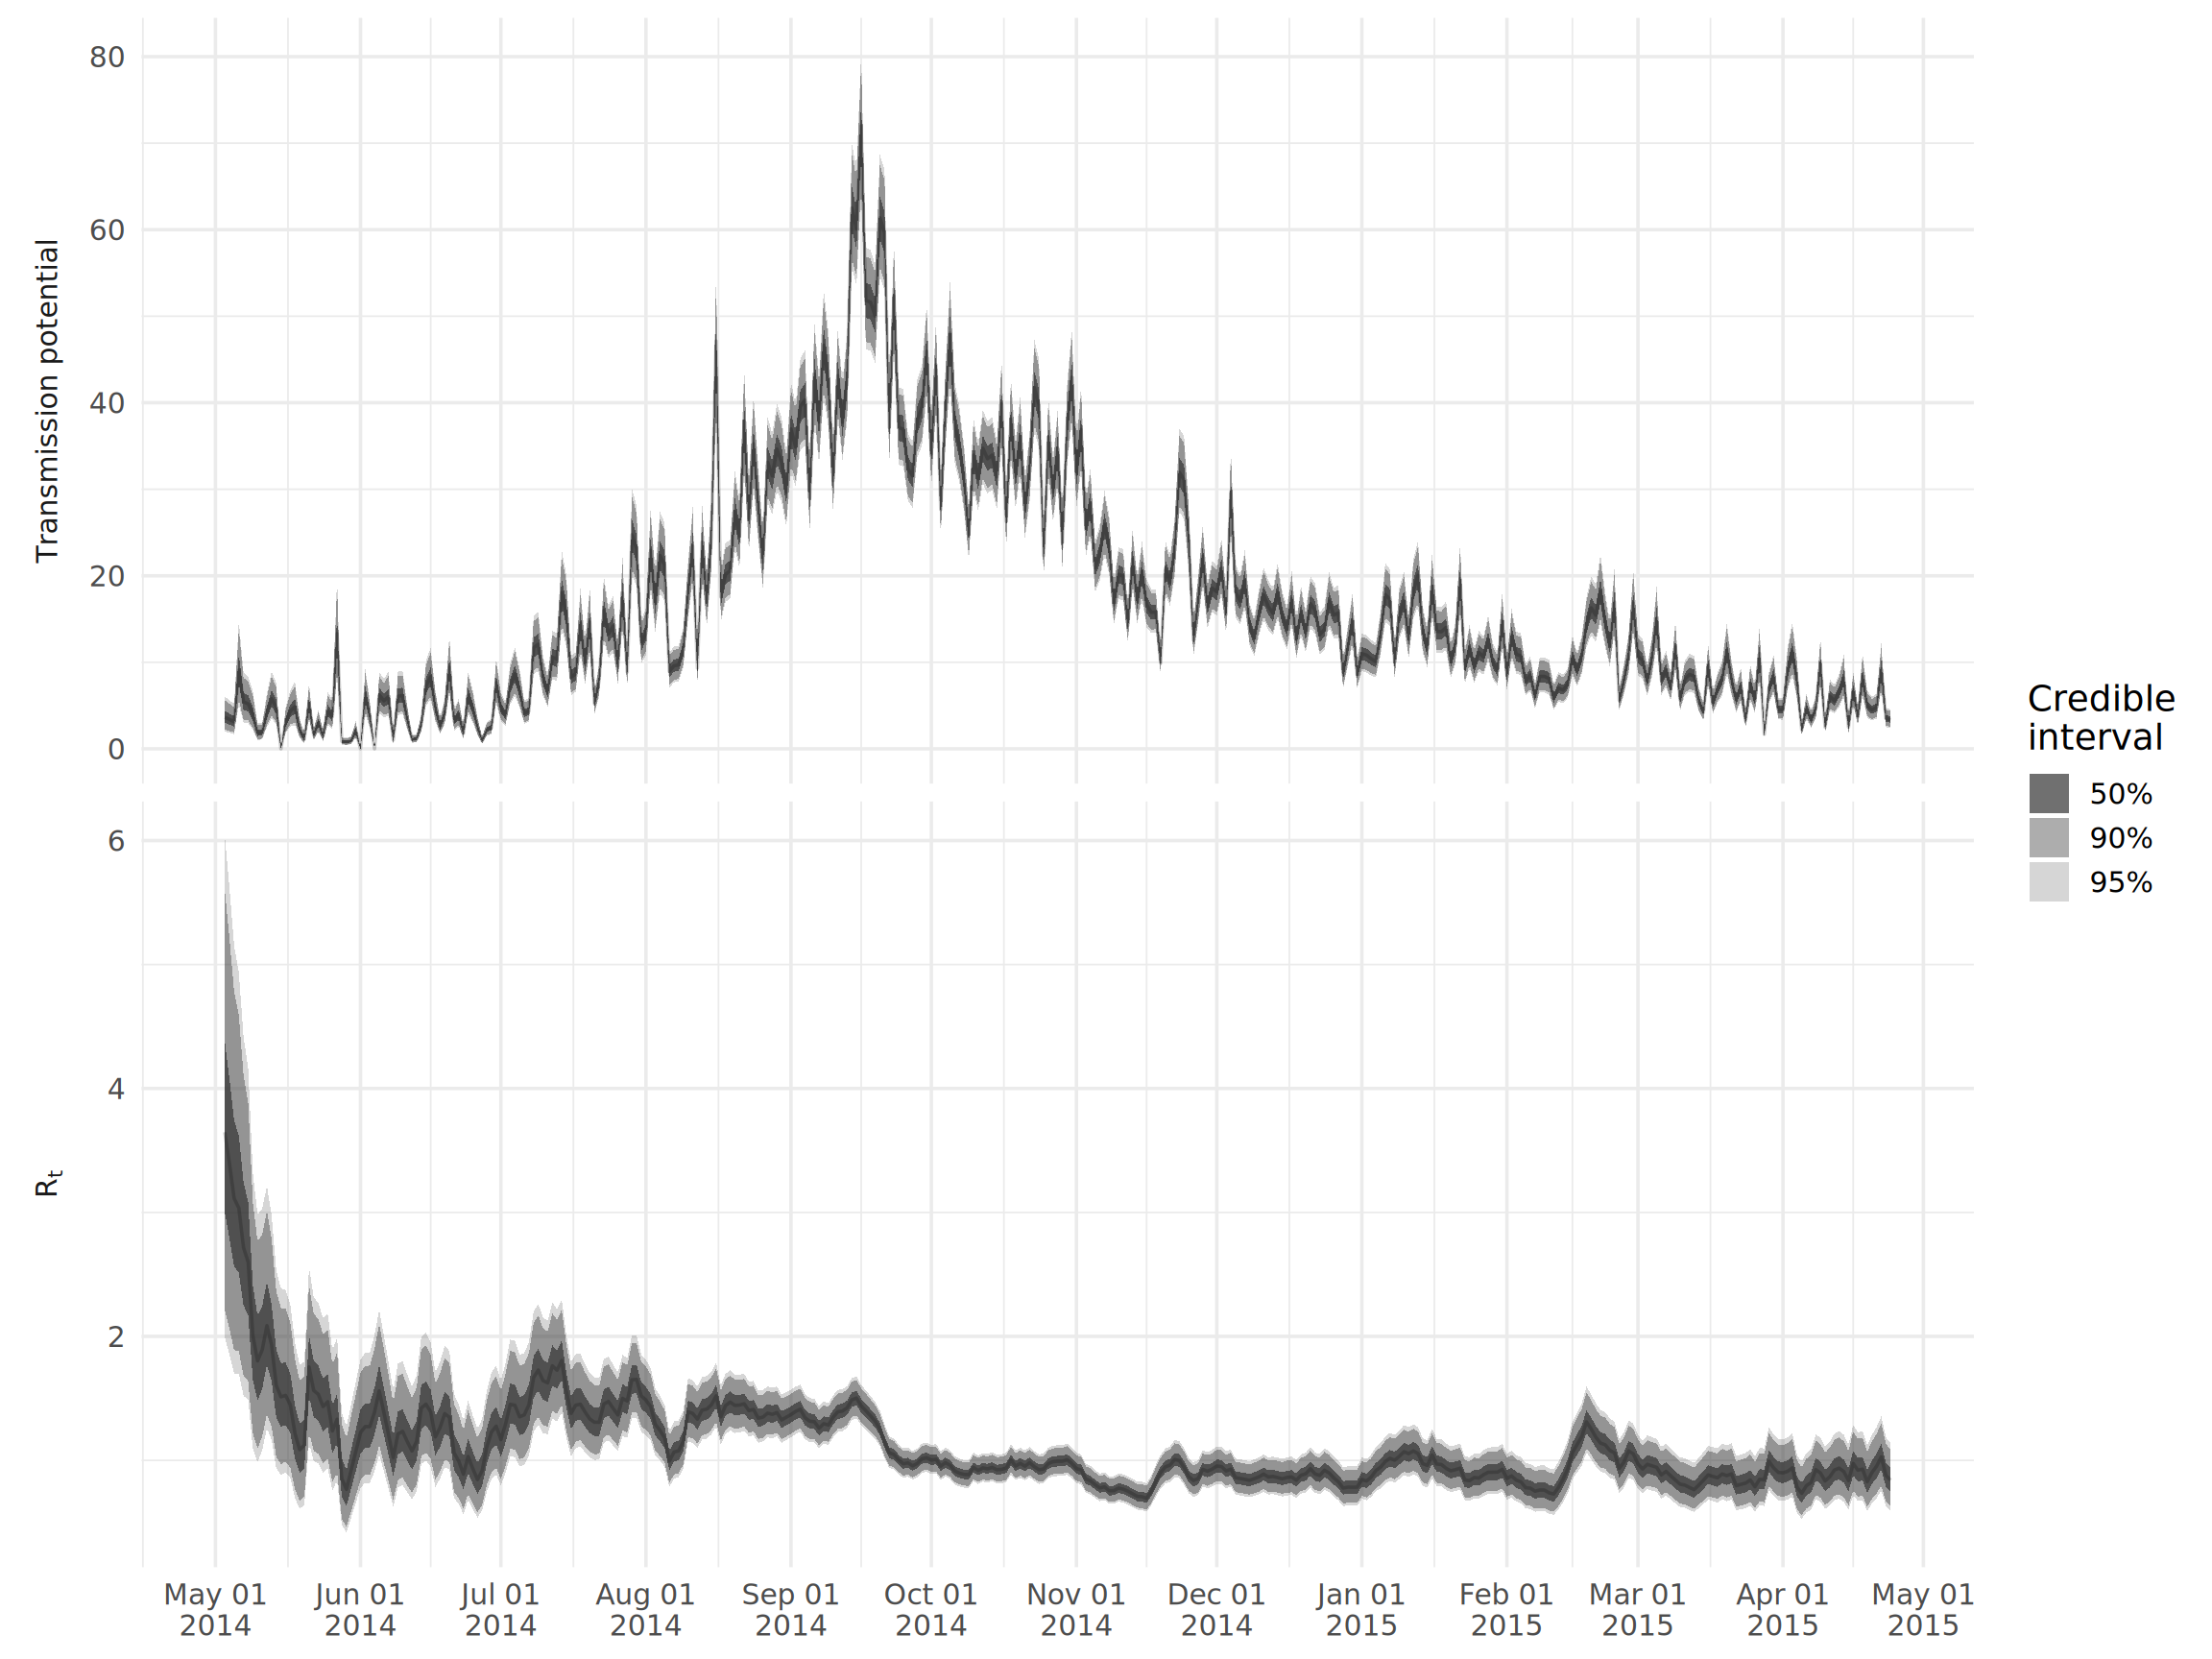
Ana çıkışlara $R üzerinden erişilebilir. Örnek olarak, bir Rt grafiği ve Rt çarpımı ve o gün rapor edilen vaka sayısı tarafından verilen bir “iletim potansiyeli” ölçüsü oluşturacağız. Bu, yeni nesil enfeksiyonda beklenen vaka sayısını temsil eder.
## medyan için geniş veri çerçevesi yapın
df_wide <- epiestim_res_lit$R %>%
  rename_all(clean_labels) %>%
  rename(
    lower_95_r = quantile_0_025_r,
    lower_90_r = quantile_0_05_r,
    lower_50_r = quantile_0_25_r,
    upper_50_r = quantile_0_75_r,
    upper_90_r = quantile_0_95_r,
    upper_95_r = quantile_0_975_r,
    ) %>%
  ## tahmini olmayan zaman pencerelerini çıkarın
  filter(!is.na(mean_r)) %>%
  mutate(
    ## medyan tarihini t_start ve t_end'den çıkarın
    dates = epiestim_res_emp$dates[round(map2_dbl(t_start, t_end, median))],
    var = "R[t]"
  ) %>%
  ## günlük insidans verilerinde birleştirme
  left_join(cases, "dates") %>%
  ## tüm r tahminlerinde riski hesapla
  mutate(
    across(
      lower_95_r:upper_95_r,
      ~ .x*I,
      .names = "{str_replace(.col, '_r', '_risk')}"
    )
  ) %>%
  ## ayrı r tahminleri ve risk tahminleri
  pivot_longer(
    contains("median"),
    names_to = c(".value", "variable"),
    names_pattern = "(.+)_(.+)"
  ) %>%
  ## faktör seviyeleri atamak
  mutate(variable = factor(variable, c("risk", "r")))

## niceliklerden uzun veri çerçevesi yapmak
df_long <- df_wide %>%
  select(-variable, -median) %>%
  ## seperate r/risk estimates and quantile levels
  pivot_longer(
    contains(c("lower", "upper")),
    names_to = c(".value", "quantile", "variable"),
    names_pattern = "(.+)_(.+)_(.+)"
  ) %>%
  mutate(variable = factor(variable, c("risk", "r")))

## grafik yapmak
ggplot() +
  geom_ribbon(
    data = df_long,
    aes(x = dates, ymin = lower, ymax = upper, alpha = quantile),
    color = NA
  ) +
  geom_line(
    data = df_wide,
    aes(x = dates, y = median),
    alpha = 0.2
  ) +
  ## alt simge etiketine izin vermek için label_parsed kullanın
  facet_wrap(
    ~ variable,
    ncol = 1,
    scales = "free_y",
    labeller = as_labeller(c(r = "R[t]", risk = "Transmission~potential"), label_parsed),
    strip.position = 'left'
  ) +
  ## nicel şeffaflığı manuel olarak tanımla
  scale_alpha_manual(
    values = c(`50` = 0.7, `90` = 0.4, `95` = 0.2),
    labels = function(x) paste0(x, "%")
  ) +
  labs(
    x = NULL,
    y = NULL,
    alpha = "Credible\ninterval"
  ) +
  scale_x_date(
    date_breaks = "1 month",
    date_labels = "%b %d\n%Y"
  ) +
  theme_minimal(base_size = 14) +
  theme(
    strip.background = element_blank(),
    strip.placement = 'outside'
  )
24.4 Tahmini insidans
EpiNow2
EpiNow2, Rt tahmininin yanı sıra Rt tahminini ve vaka sayılarının projeksiyonlarını da destekler. Tek yapmanız gereken, ‘epinow’ fonksiyon çağrınızda forecast değişkenine forecast_opts(horizon = 21) vermek. horizon, geleceğe kaç gün yansıtmak istediğinizdir. EpiNow2’nin nasıl kurulup çalıştırılacağına ilişkin ayrıntılar için “Rt Tahmini” altındaki EpiNow2 bölümüne bakabilirsiniz. Bu bölümde, kaydedilmiş modelin tahminini çizeceğiz.
## grafik için minimum tarihi belirleyin
min_date <- as.Date("2015-03-01")

## kaydedilmiş modelin özet tahminlerini yükleyin
estimates <- as_tibble(appliedepidata::get_data(name = "epidemic_models_summarised_estimates"))

## kaydedilmiş modelin kullandığı vaka sayılarını yükleyin
observations <- as_tibble(appliedepidata::get_data(name = "epidemic_models_reported_cases")) %>%
  filter(date > min_date)

## vaka sayılarının öngörülen tahminlerini çıkarın
df_wide <- estimates %>%
  filter(
    variable == "reported_cases",
    type == "forecast",
    date > min_date
  )

## nicel çizim için daha da uzun formata dönüştürün
df_long <- df_wide %>%
  ## burada eşleşen nicelikleri eşleştiriyoruz (örneğin, alt_90 ila üst_90)
  pivot_longer(
    lower_90:upper_90,
    names_to = c(".value", "quantile"),
    names_pattern = "(.+)_(.+)"
  )

## çizimi yapın
ggplot() +
  geom_col(
    data = observations,
    aes(x = date, y = confirm),
    width = 1
  ) +
  geom_ribbon(
    data = df_long,
    aes(x = date, ymin = lower, ymax = upper, alpha = quantile),
    color = NA
  ) +
  geom_line(
    data = df_wide,
    aes(x = date, y = median)
  ) +
  geom_vline(xintercept = min(df_long$date), linetype = 2) +
  ## nicel şeffaflığı manuel olarak tanımla
  scale_alpha_manual(
    values = c(`20` = 0.7, `50` = 0.4, `90` = 0.2),
    labels = function(x) paste0(x, "%")
  ) +
  labs(
    x = NULL,
    y = "Daily reported cases",
    alpha = "Credible\ninterval"
  ) +
  scale_x_date(
    date_breaks = "1 month",
    date_labels = "%b %d\n%Y"
  ) +
  theme_minimal(base_size = 14)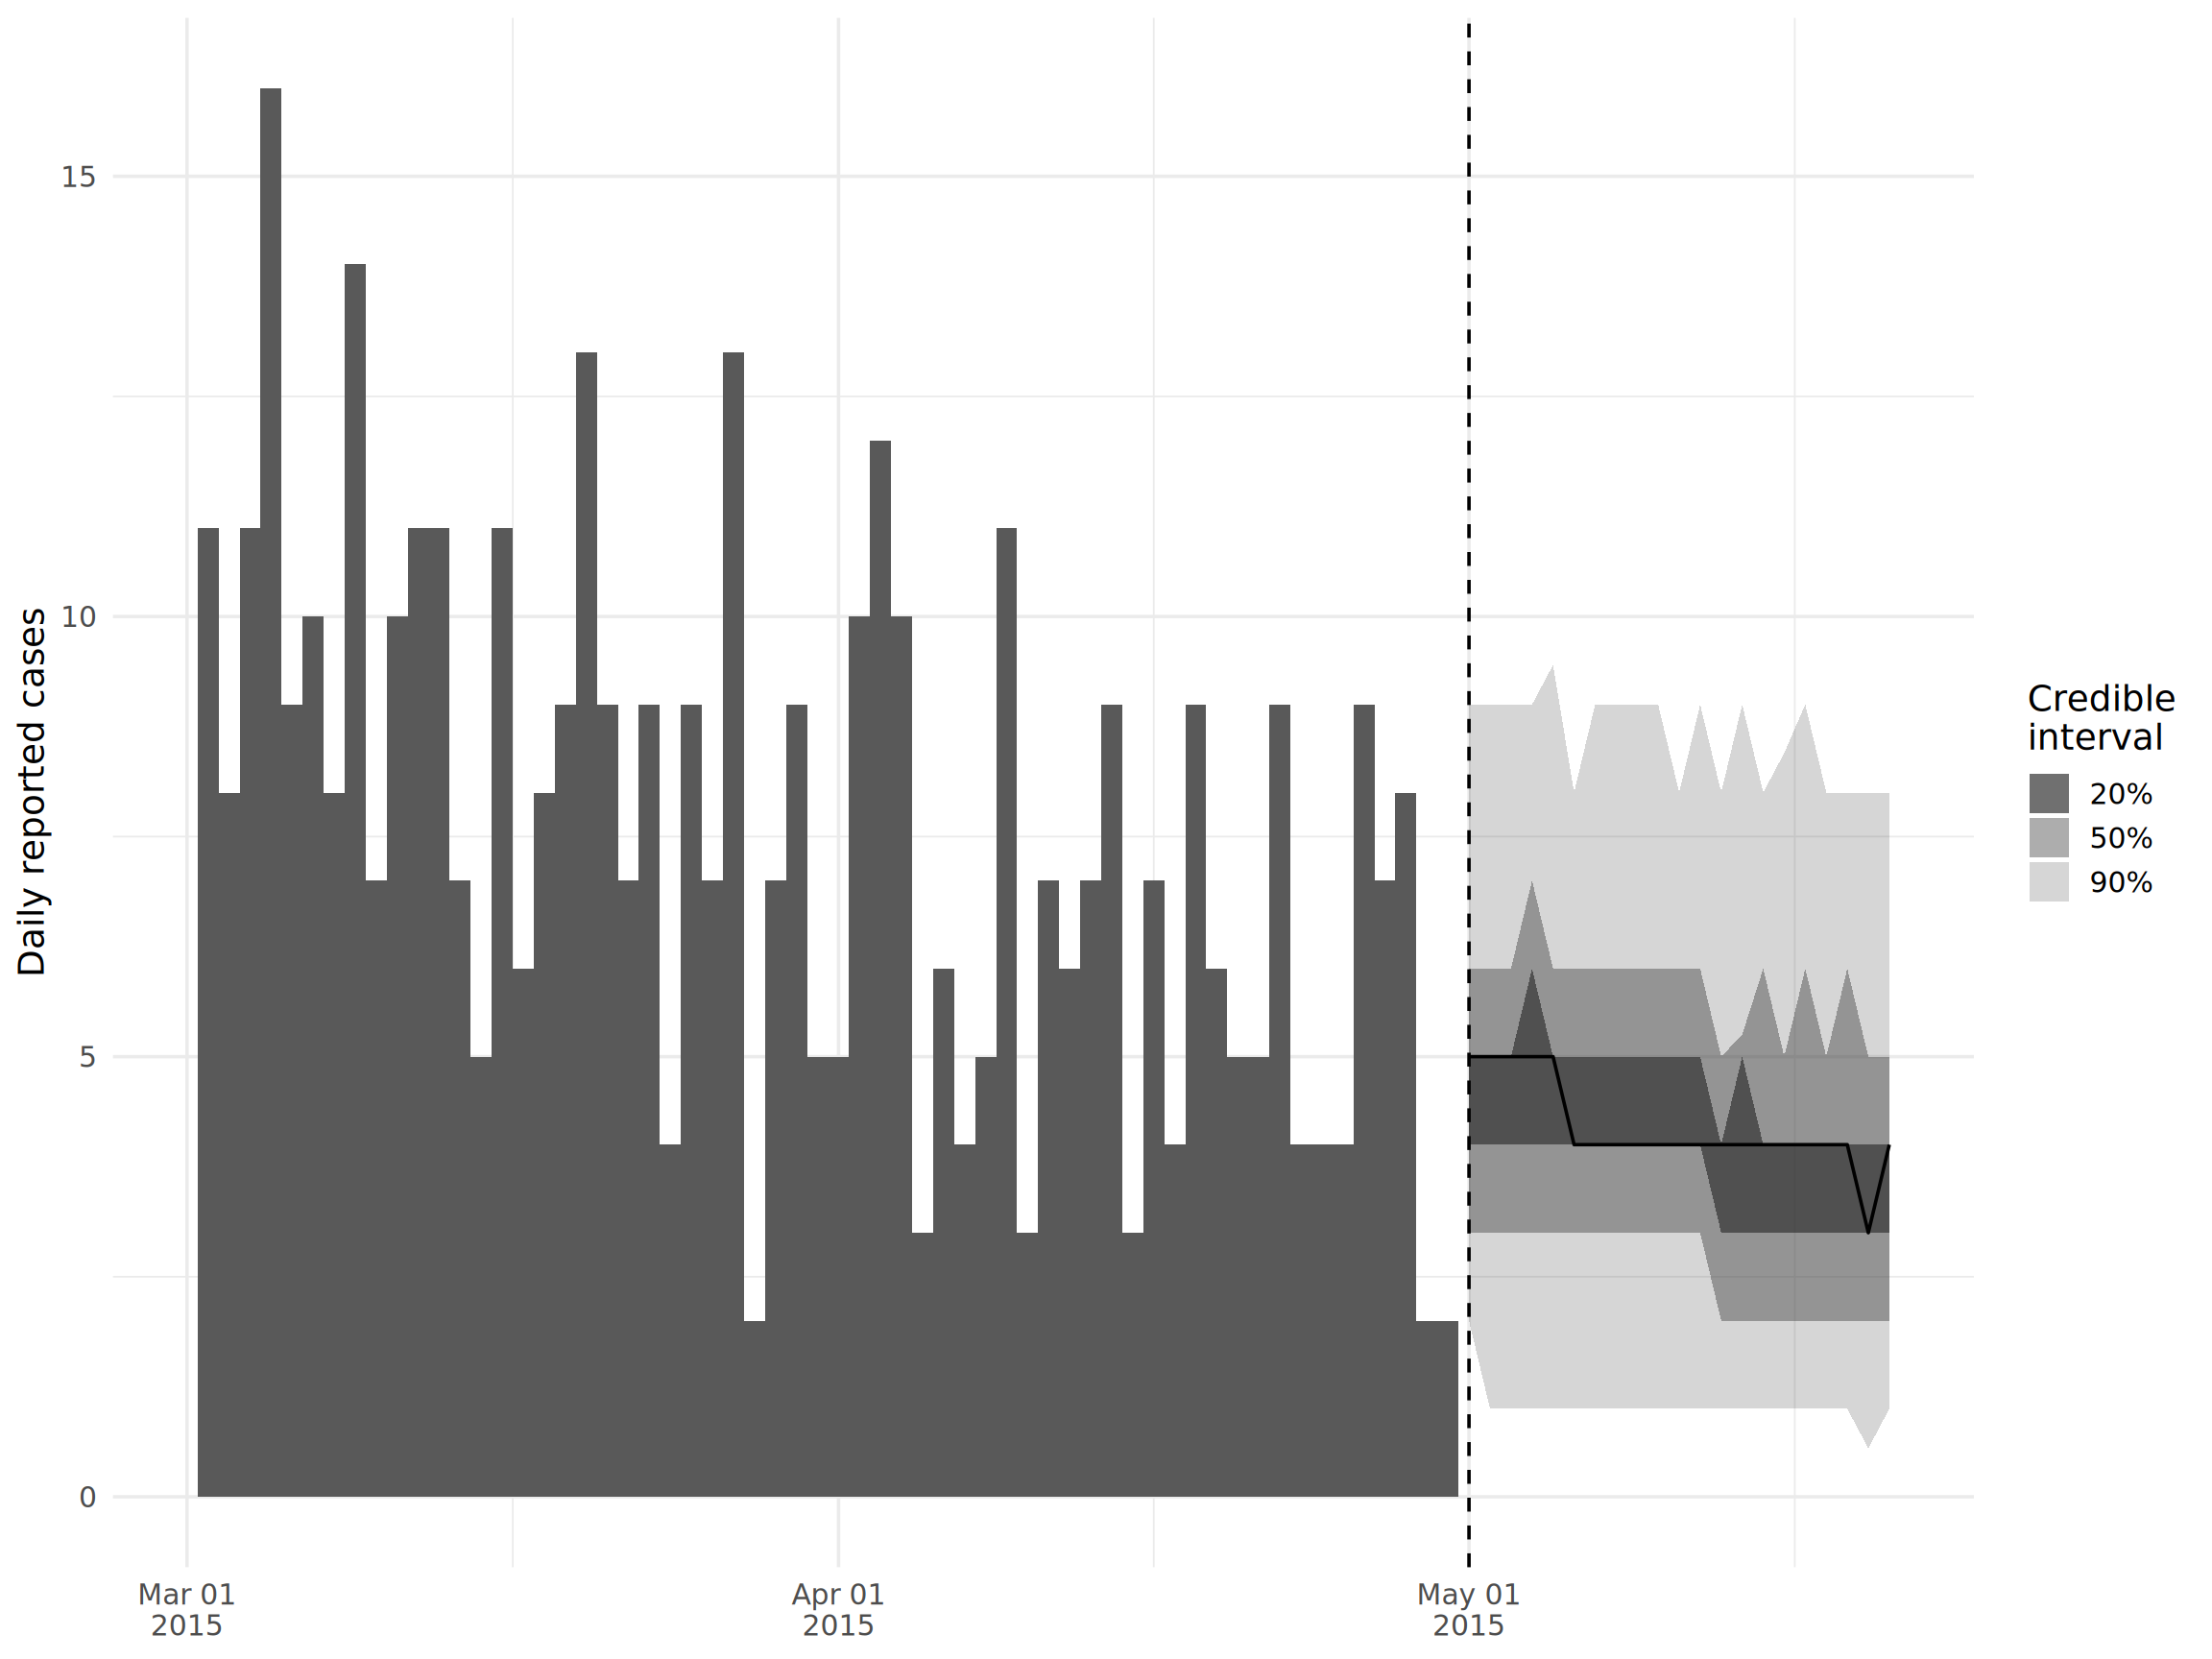
Projeksiyonlar
RECON tarafından geliştirilen projeksiyonlar paketi, etkin üreme sayısı Rt ve seri aralığı hakkında bilgi gerektiren kısa vadeli insidans tahminleri yapmayı çok kolaylaştırır. Burada literatürden seri aralık tahminlerinin nasıl kullanılacağını ve satır listesinden kendi tahminlerimizin nasıl kullanılacağını ele alacağız.
Literatürden seri aralık tahminlerini kullanma
projeksiyonlar, discrete paketinden ‘discrete’ sınıfının ayrık bir seri aralık dağılımını gerektirir. Bu yazıda tanımlanan ortalama 12.0 ve standart sapması 5.2 olan bir gama dağılımı kullanacağız. Bu değerleri bir gama dağılımı için gereken şekil ve ölçek parametrelerine dönüştürmek için, epitrix paketindeki ‘gamma_mucv2shapescale’ fonkdiyonunu kullanacağız.
## ortalama mu ve katsayısından şekil ve ölçek parametreleri alın
## varyasyon (ör. standart sapmanın ortalamaya oranı)
shapescale <- epitrix::gamma_mucv2shapescale(mu = 12.0, cv = 5.2/12)

## ayrık nesne yapmak
serial_interval_lit <- distcrete::distcrete(
  name = "gamma",
  interval = 1,
  shape = shapescale$shape,
  scale = shapescale$scale
)
İşte seri aralığın doğru göründüğünden emin olmak için hızlı bir kontrol. Az önce tanımladığımız gama dağılımının yoğunluğuna, ‘dgamma’ çağırmaya eşdeğer olan ‘$d’ ile erişiriz:
## seri aralığın doğru göründüğünden emin olmak için kontrol edin
ggplot(
  data = tibble(x = 0:50, y = serial_interval_lit$d(0:50)),
  aes(x = x, y = y)
) +
  geom_area() +
  labs(x = "Serial interval", y = "Density")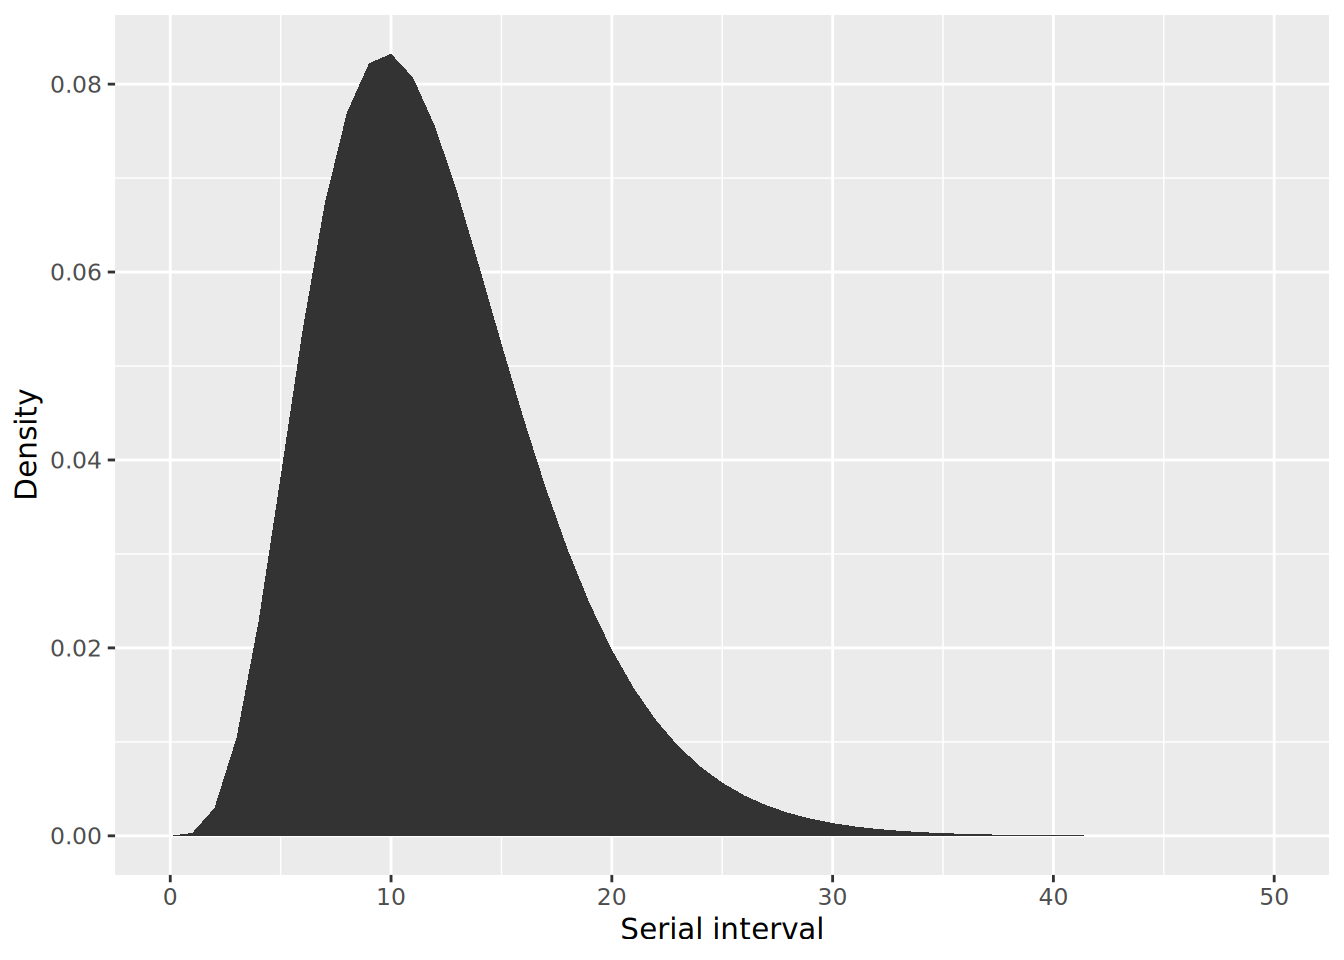
Verilerinden seri aralık tahminlerini kullanma
Semptom başlangıç tarihlerine ve iletim bağlantılarına ilişkin verilere sahip olduğumuz için, bulaştırıcı-enfekte çiftlerinin başlangıç tarihleri arasındaki gecikmeyi hesaplayarak satır listesinden seri aralığı da tahmin edebiliriz. EpiNow2 bölümünde yaptığımız gibi, epicontacts paketindeki get_pairwise fonksiyonunu kullanacağız. Bu da iletim çiftleri arasındaki satır listesi özelliklerinin ikili farklarını hesaplamamıza izin verir. Önce bir epicontacts nesnesi oluşturuyoruz (daha fazla ayrıntı için [İletim zincirleri] sayfasına bakabilirsiniz:
## kişileri üretin
contacts <- linelist %>%
  transmute(
    from = infector,
    to = case_id
  ) %>%
  drop_na()

## temaslı kişileri üretin
epic <- make_epicontacts(
  linelist = linelist,
  contacts = contacts,
  directed = TRUE
)
Daha sonra iletim çiftleri arasındaki başlangıç tarihlerindeki farkı bir gama dağılımına uydururuz, “get_pairwise” kullanarak hesaplarız. Ayrık bir dağıtım gerektirdiğinden, bu yerleştirme prosedürü için epitrix paketindeki kullanışlı ’fit_disc_gamma’yı kullanıyoruz.
## gama seri aralığını tahmin edin, başlangıç tarihi olmayan çiftler hariç
serial_interval <- fit_disc_gamma(na.omit(get_pairwise(epic, "date_onset")))

## tahmini inceleme
serial_interval[c("mu", "sd")]
$mu
[1] 11.51047
$sd
[1] 7.696056Tahmini insidans
Gelecekteki vakaları tahmin etmek için, yine de bir “insidans” nesnesi şeklinde tarihsel vakayı ve ayrıca makul Rt değerleri örneğini sağlamamız gerekiyor. Bu değerleri, önceki bölümde (“Tahmini Rt” başlığı altında) EpiEstim tarafından oluşturulan ve ‘epiestim_res_emp’ nesnesi içinde depolanan Rt tahminlerini kullanarak üreteceğiz. Aşağıdaki kodda, Rt için ortalama ve standart sapma tahminlerini çıkarıyoruz. Salgının son zaman penceresi (bir vektördeki son öğeye erişmek için “tail” fonksiyonunu kullanarak) ve “rgamma” kullanarak bir gama dağılımından 1000 değeri simüle edin. İleriye dönük projeksiyonlar için kullanmak istediğiniz kendi Rt değerleri vektörünüzü de sağlayabilirsiniz.
## başlangıç tarihlerinden incidence nesnesi oluşturun, başlangıç tarihi olmayan vakalar hariç
inc <- incidence::incidence(na.omit(linelist$date_onset))

## en son tahminden makul r değerleri çıkar
mean_r <- tail(epiestim_res_emp$R$`Mean(R)`, 1)
sd_r <- tail(epiestim_res_emp$R$`Std(R)`, 1)
shapescale <- gamma_mucv2shapescale(mu = mean_r, cv = sd_r/mean_r)
plausible_r <- rgamma(1000, shape = shapescale$shape, scale = shapescale$scale)

## dağıtımı kontrol et
ggplot(data = tibble(r = plausible_r), aes(x = r)) +
  geom_histogram(bins = 30) +
  labs(x = expression(R[t]), y = "Counts")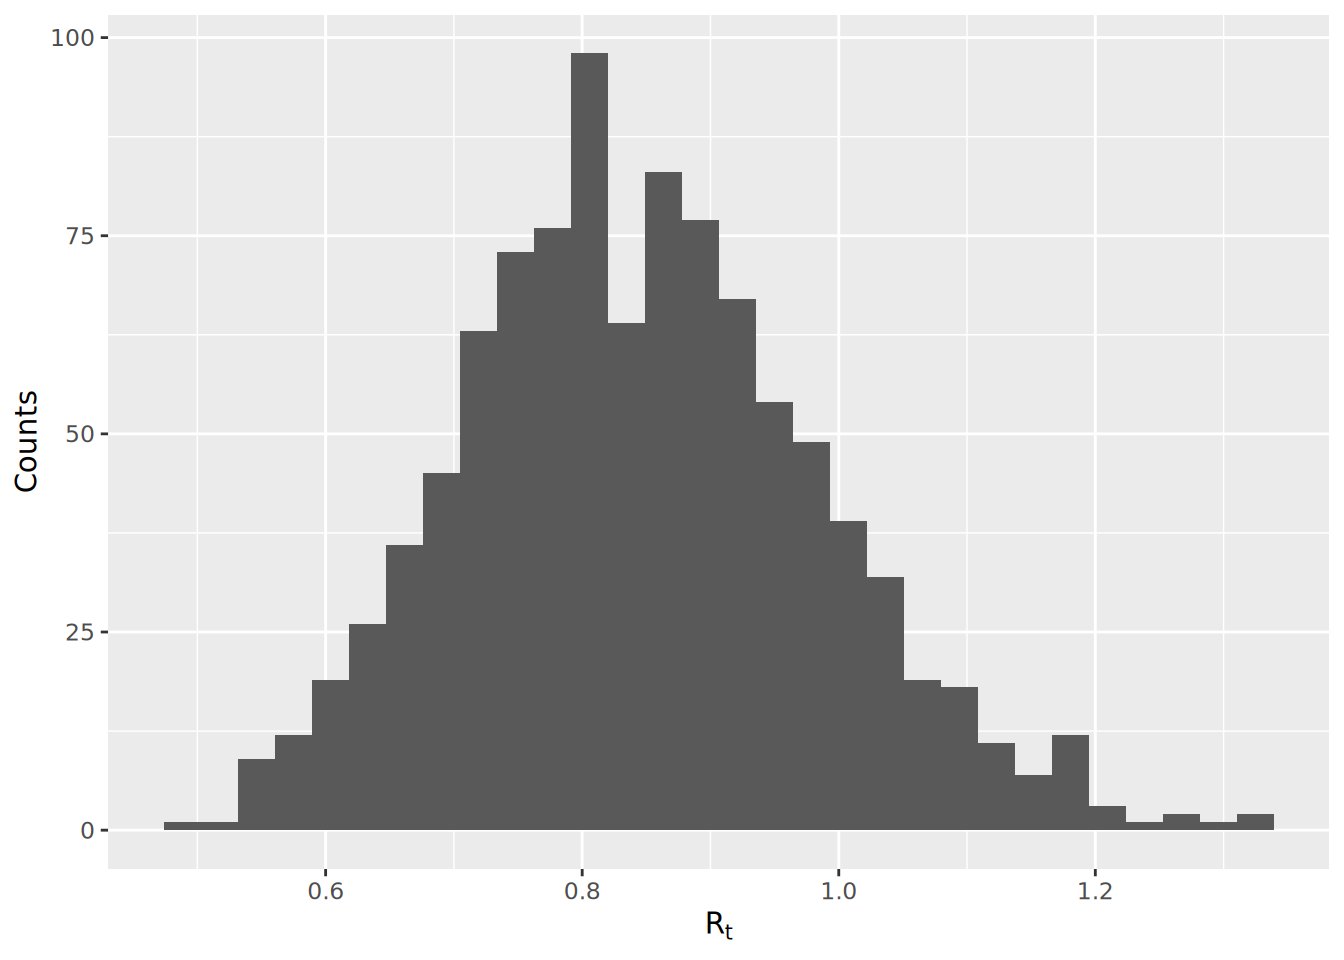
Daha sonra gerçek tahmini yapmak için project() fonksiyonunu kullanırız. ‘n_days’ değişkenleri ile kaç gün için projeksiyon yapmak istediğimizi ve ‘n_sim’ değişkeni kullanarak simülasyonların sayısını belirliyoruz.
## projeksiyon yapma
proj <- project(
  x = inc,
  R = plausible_r,
  si = serial_interval$distribution,
  n_days = 21,
  n_sim = 1000
)
Daha sonra insidansı ggplot2 ile çizebilir ve projeksiyonları ‘add_projections()’ fonksiyonu ile ekleyebiliriz. incidence paketinin plot() fonksiyonu ggplot2’den bir kullanımdan kaldırma uyarısı verir, bu nedenle onu kullanmıyoruz. Köşeli parantez operatörünü kullanarak yalnızca en son durumları göstermek için ‘insidans’ nesnesini kolayca alt kümeye koyabiliriz.
## insidansı çizin
incidence_plot <- ggplot() +
  geom_col(
    data = as.data.frame(inc[inc$dates > as.Date("2015-03-01")]),
    aes(x = dates, y = counts),
    width = 1
  ) +
  theme_minimal(base_size = 14)

## projeksiyonları ekleyin
add_projections(incidence_plot, proj)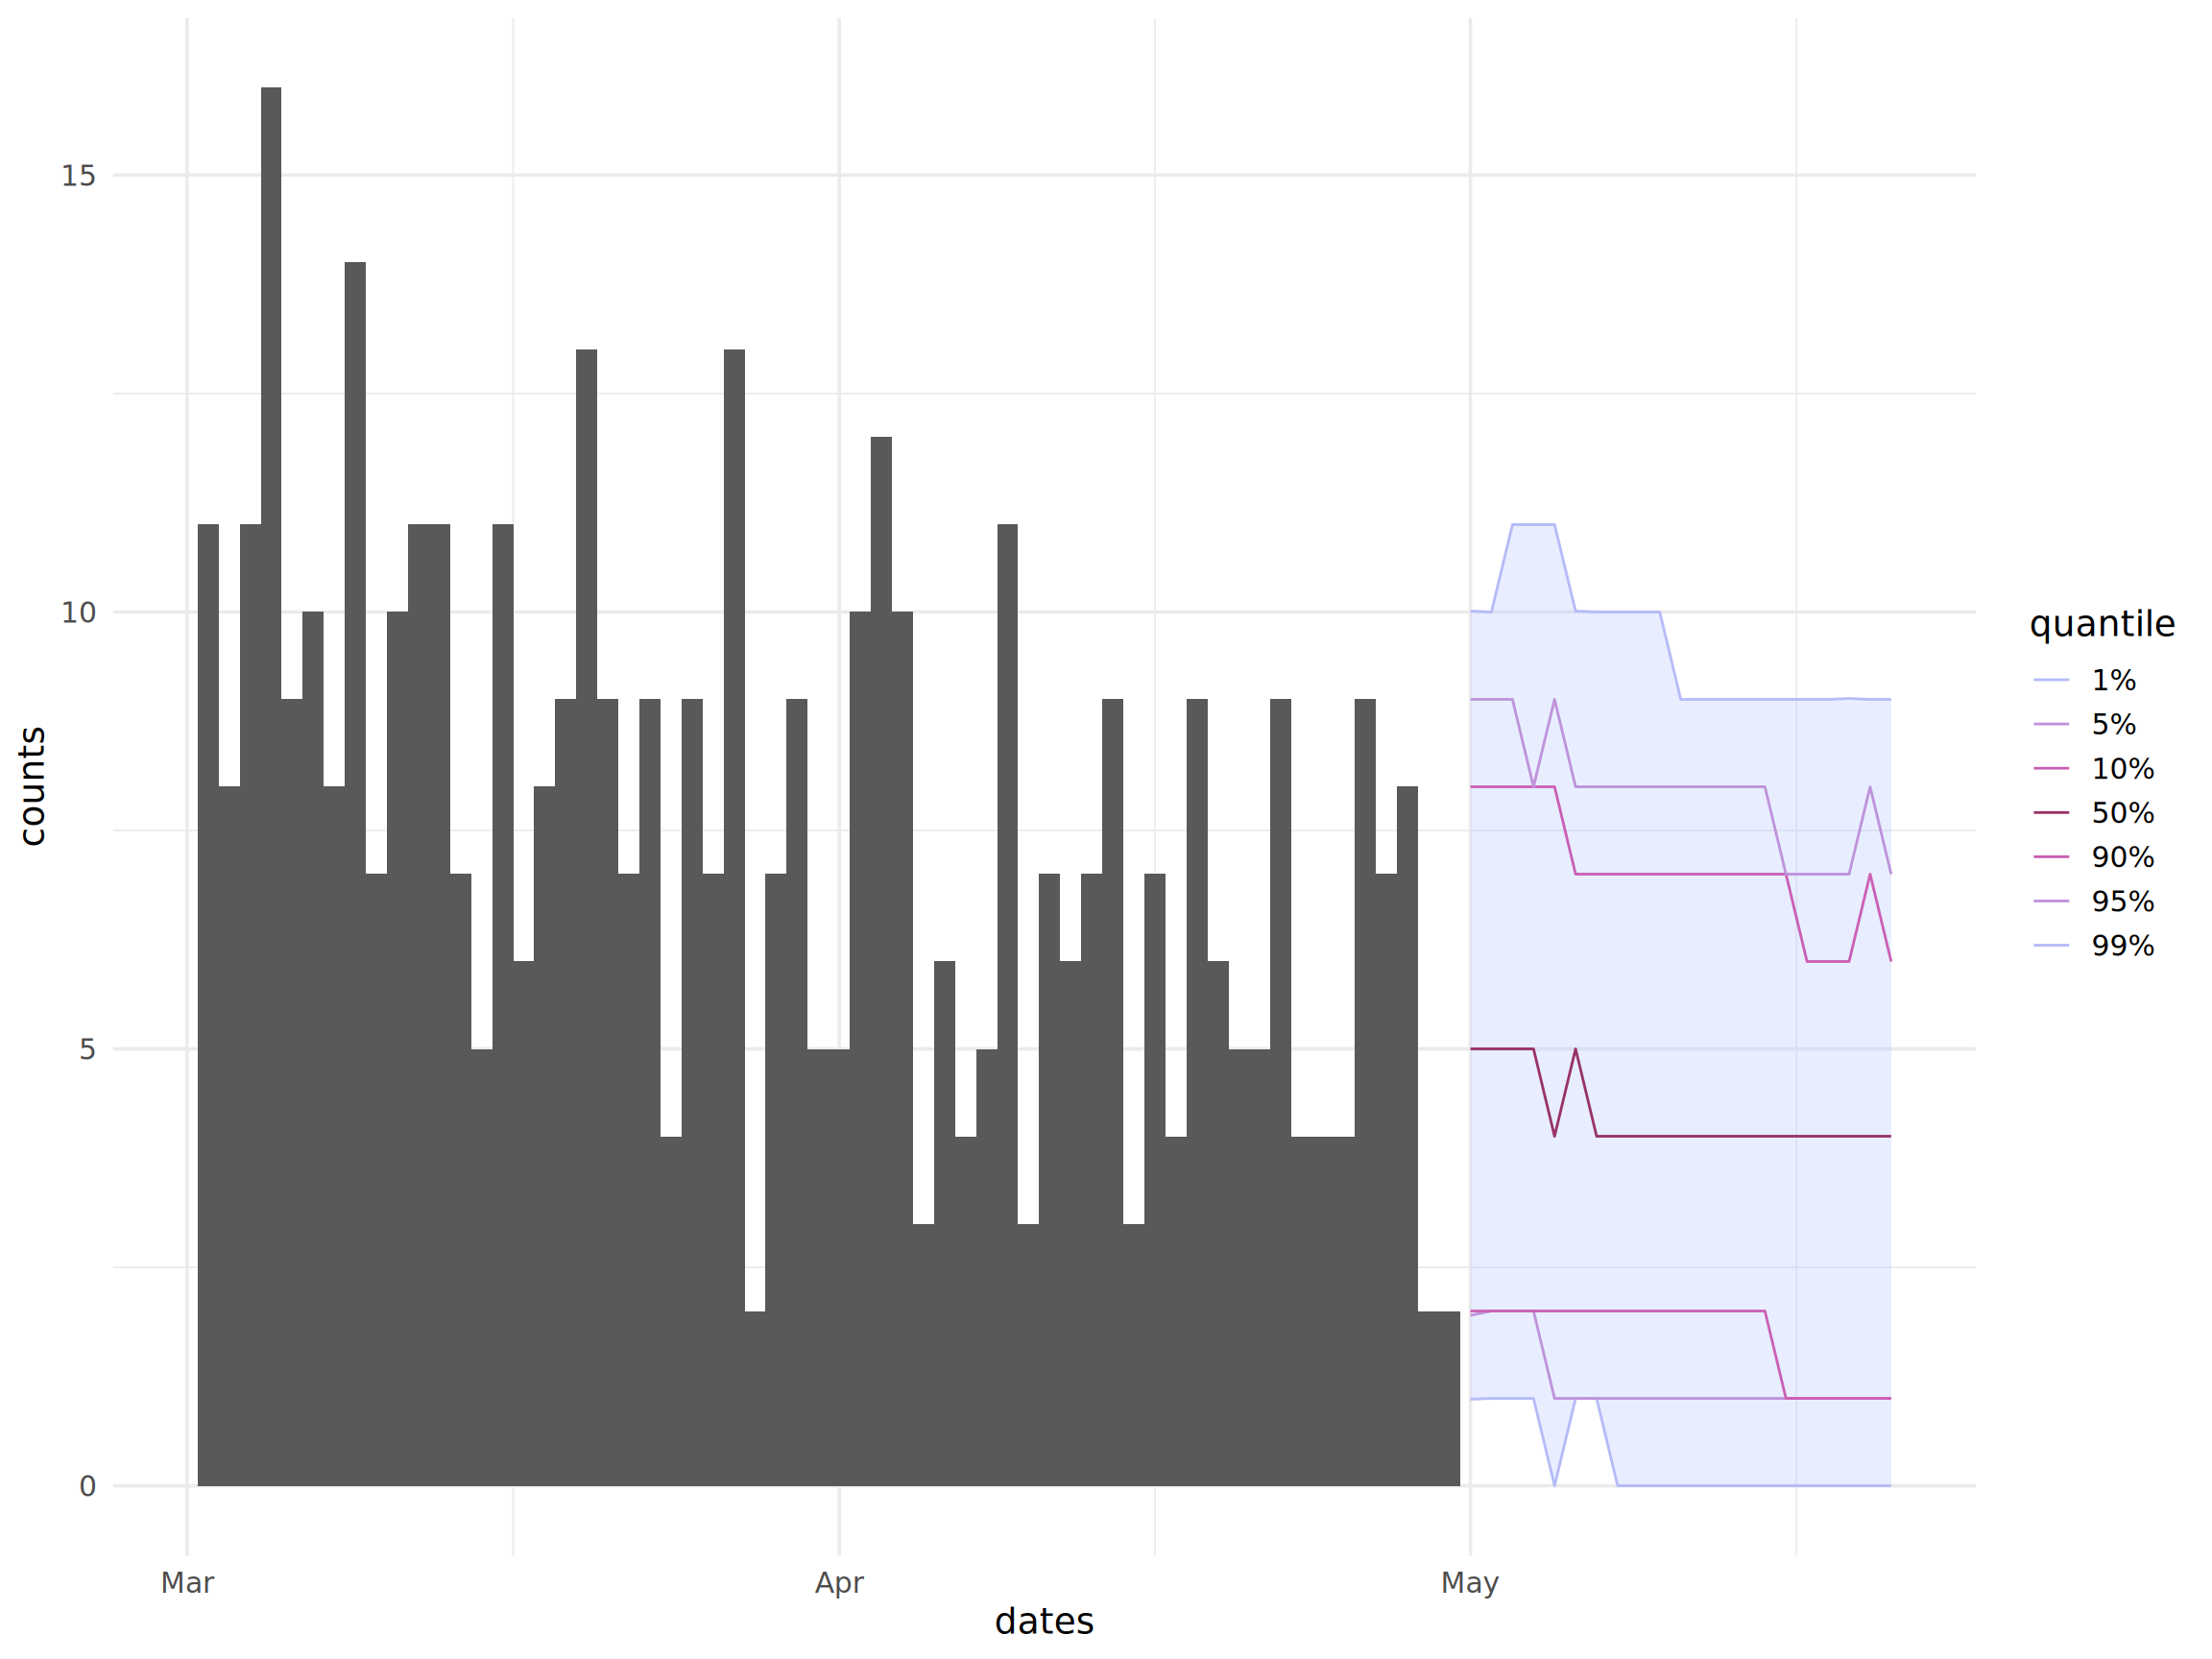
Çıktıyı bir veri çerçevesine dönüştürerek günlük vaka sayılarının ham tahminlerini de kolayca çıkarabilirsiniz.
## ham veriler için veri çerçevesine dönüştür
proj_df <- as.data.frame(proj)
proj_df